MCP: a tentativa de acabar com o pesadelo das integrações entre inteligência artificial e ferramentas

 Conectar um modelo de inteligência artificial a uma ferramenta parece simples até o momento em que essa conexão precisa funcionar de verdade, com segurança, diferentes usuários, permissões, atualizações e dezenas de serviços ao mesmo tempo.
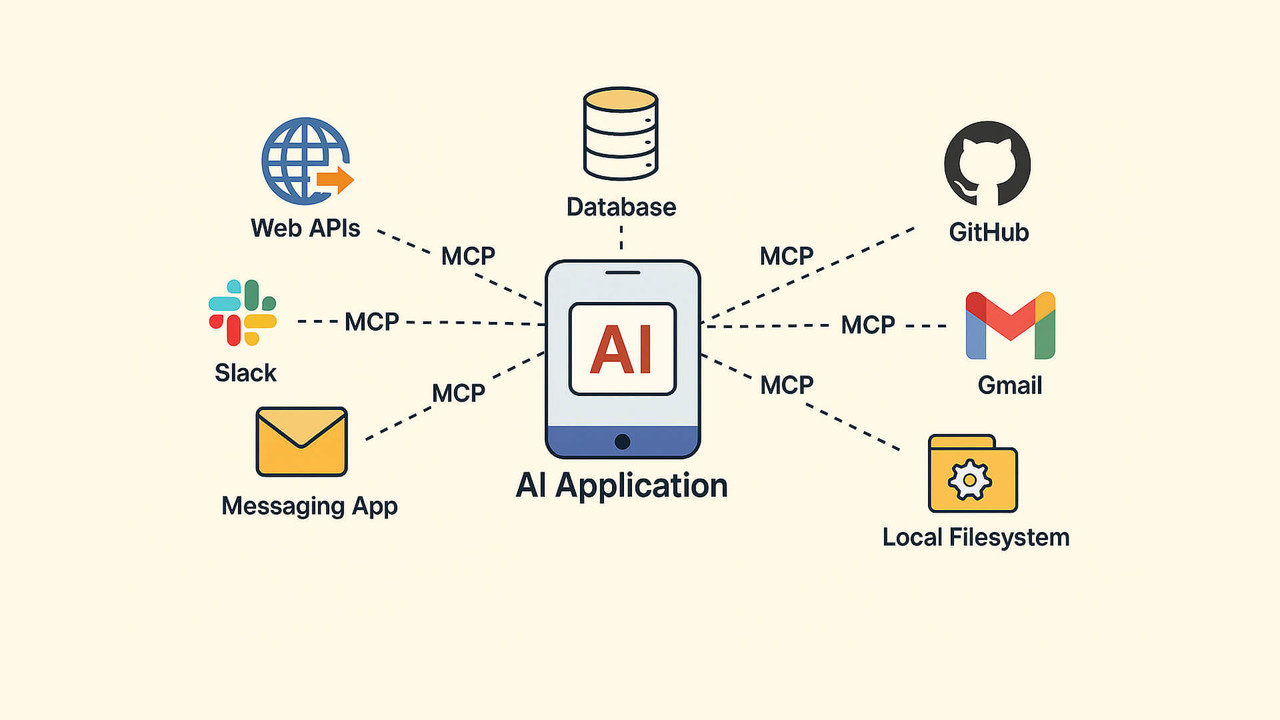
Representação da arquitetura do Model Context Protocol conectando modelos de inteligência artificial a bancos de dados, APIs e ferramentas
O MCP cria uma camada padronizada entre aplicações de inteligência artificial e ferramentas externas.

Durante algum tempo, boa parte da indústria tratou esse problema como se bastasse criar mais uma integração. O modelo precisa consultar um banco PostgreSQL? Fazemos um conector. Precisa buscar arquivos no Google Drive? Criamos outro. Agora também precisa acessar o GitHub, um CRM, uma API financeira e o sistema interno da empresa? Então surgem mais quatro integrações, cada uma com autenticação, documentação, formatos de resposta e tratamento de erros próprios.

Funciona. Pelo menos no começo.

A dificuldade aparece quando multiplicamos o número de modelos pelo número de ferramentas. Se uma empresa trabalha com cinco aplicações de inteligência artificial e pretende conectá-las a vinte serviços, não existe apenas um problema de vinte integrações. Dependendo da arquitetura escolhida, podemos terminar com dezenas ou até centenas de combinações que precisam ser desenvolvidas, testadas, atualizadas e monitoradas.

É nesse cenário que entra o Model Context Protocol, mais conhecido como MCP. Ele não elimina APIs, não transforma automaticamente qualquer sistema em uma ferramenta segura e também não concede poderes mágicos a um modelo. Sua proposta é mais concreta: criar uma interface padronizada por meio da qual aplicações de IA possam descobrir e utilizar ferramentas, recursos e fluxos externos.

A ideia lembra outros momentos da história da computação em que um padrão comum reduziu a necessidade de construir conexões específicas para tudo. Não é difícil entender por que o MCP costuma ser comparado a uma espécie de USB-C para aplicações de inteligência artificial. A analogia não é perfeita, mas mostra o essencial: em vez de inventar um encaixe diferente para cada combinação, define-se uma forma comum de comunicação.

O problema não é apenas chamar uma API

APIs HTTP tradicionais já permitem que programas conversem entre si há muito tempo. Um sistema pode enviar uma requisição, receber um JSON, interpretar os campos e continuar seu trabalho. Não há nada de ultrapassado nisso. Na realidade, muitos servidores MCP continuam dependendo dessas mesmas APIs nos bastidores.

Dizer que as APIs tradicionais foram “feitas para humanos” também simplifica demais a questão. Elas são contratos entre softwares. O que acontece é que sua documentação, seus endpoints e seus modelos de autenticação geralmente foram organizados para que um programador escreva antecipadamente o código da integração.

Imagine uma API de vendas com endpoints como:

  • GET /customers;
  • GET /orders/{id};
  • POST /orders;
  • PATCH /customers/{id}.

Um desenvolvedor lê a documentação, entende os parâmetros, programa as chamadas e determina o que será feito com as respostas. A aplicação já nasce sabendo quais endpoints existem e como usá-los.

Um modelo de linguagem opera de outra maneira. Ele precisa receber uma descrição compreensível das ações disponíveis, conhecer os argumentos aceitos, decidir qual ação corresponde ao pedido do usuário e interpretar o resultado sem confundir dados com instruções. Simplesmente jogar uma documentação REST inteira no contexto do modelo seria caro, impreciso e perigoso.

O MCP cria uma camada intermediária para organizar essa interação. Um servidor pode expor uma ferramenta chamada consultar_pedido, informar que ela exige o campo numero_pedido e descrever qual resultado será devolvido. A aplicação de IA apresenta essa definição ao modelo. Quando o usuário pergunta onde está sua encomenda, o modelo pode selecionar a ferramenta e preencher o argumento necessário.

Abaixo dessa interface talvez ainda exista uma requisição HTTP tradicional. O servidor MCP pode receber a chamada, consultar uma API de logística, tratar a resposta e devolver um conteúdo estruturado. O MCP não substituiu a API da transportadora. Ele padronizou a maneira como a capacidade dessa API é apresentada à aplicação de IA.

Essa diferença é pequena na aparência e enorme na manutenção.

A explosão combinatória das integrações

Sem uma camada comum, cada fornecedor tende a criar seu próprio sistema de plugins, funções, conectores ou chamadas de ferramentas. Um mesmo banco de dados pode precisar de adaptações diferentes para funcionar em um chatbot, um editor de código, um agente corporativo e uma aplicação local.

Mudanças também se acumulam. A API modifica uma rota. O provedor do modelo altera o formato das chamadas de função. O mecanismo de autenticação recebe uma nova exigência. O JSON devolvido pela ferramenta muda. Uma correção precisa ser aplicada em vários conectores que realizam praticamente o mesmo trabalho.

É um pesadelo discreto. O usuário final não o vê, mas alguém está mantendo tudo isso.

O MCP tenta separar as responsabilidades. Quem desenvolve a aplicação de IA implementa um cliente compatível com o protocolo. Quem deseja disponibilizar uma ferramenta implementa um servidor MCP. A partir daí, diferentes clientes podem conversar com diferentes servidores usando os mesmos conceitos básicos.

Quando a Anthropic apresentou publicamente o MCP em novembro de 2024, descreveu justamente o problema dos sistemas de IA isolados em silos e da necessidade de uma implementação personalizada para cada nova fonte de dados. O protocolo foi lançado como um padrão aberto para conectar aplicações de IA a repositórios, ferramentas empresariais e ambientes de desenvolvimento. Em dezembro de 2025, o projeto foi doado à Agentic AI Foundation, vinculada à Linux Foundation, ampliando sua governança para além de uma única empresa. Anthropic — apresentação do MCP e doação à Agentic AI Foundation.

Isso importa porque um protocolo de integração perde boa parte de seu valor se estiver preso aos interesses comerciais de apenas um fornecedor.

O MCP não é “melhor que HTTP”

Aqui existe uma confusão frequente. MCP e HTTP não ocupam exatamente a mesma camada.

HTTP é um protocolo de transporte e comunicação usado em grande parte da web. O MCP define mensagens, capacidades e formas padronizadas de expor ferramentas e contexto para aplicações de IA. Essas mensagens podem ser transportadas de maneiras diferentes.

A especificação atual prevê, entre outras possibilidades, o uso de stdio, em que uma aplicação inicia um processo local e troca mensagens pela entrada e saída padrão, e o Streamable HTTP, no qual as mensagens MCP são enviadas a um endpoint HTTP. O conteúdo do protocolo utiliza JSON-RPC. Em outras palavras: MCP pode funcionar sobre HTTP. Especificação dos transportes MCP.

Uma comparação mais correta seria dizer que uma API convencional oferece operações de um sistema, enquanto um servidor MCP reorganiza operações, dados e descrições para que uma aplicação de IA consiga descobri-los e utilizá-los por meio de um contrato comum.

Ele funciona como adaptador, mas não necessariamente como tradutor de linguagem natural. A tradução mais importante acontece entre dois modelos de interação: de um lado, APIs, bancos de dados, arquivos e funções com particularidades próprias; do outro, uma aplicação de IA que espera receber ferramentas descritas de maneira estruturada.

O servidor também pode simplificar respostas enormes. Uma API talvez devolva cinquenta campos sobre um pedido, enquanto o modelo precisa apenas do status, da previsão de entrega e do código de rastreamento. O servidor MCP pode filtrar os dados e apresentar somente o necessário. Isso reduz ruído e, quando bem implementado, diminui o consumo de contexto.

Mas essa filtragem não ocorre por obrigação. Um servidor mal planejado pode despejar dados demais, expor informações sensíveis ou fornecer descrições ambíguas. O protocolo oferece uma estrutura. A qualidade continua dependendo de quem constrói a integração.

Descoberta dinâmica: a IA pergunta o que está disponível

Uma das diferenças mais úteis do MCP está na descoberta de capacidades.

Em uma integração tradicional, o programador normalmente define previamente quais operações serão usadas. No MCP, o cliente pode consultar o servidor e receber uma lista das ferramentas disponíveis, acompanhada de nomes, descrições e esquemas de entrada.

Uma ferramenta de consulta meteorológica, por exemplo, poderia informar:

  • nome: consultar_clima;
  • descrição: consulta as condições meteorológicas de uma localidade;
  • entrada obrigatória: local;
  • entrada opcional: unidade;
  • unidades aceitas: Celsius ou Fahrenheit.

Com essas informações, o modelo consegue avaliar se a ferramenta atende ao pedido do usuário. Não é necessário gravar no prompt uma lista fixa e eterna de tudo o que o servidor possui.

Na especificação MCP, o cliente pode usar operações como tools/list para conhecer as ferramentas e tools/call para executar uma delas. Recursos e prompts também possuem mecanismos próprios de listagem. O servidor pode informar que oferece notificações quando a lista é modificada, permitindo que o cliente atualize seu registro. Visão geral da arquitetura MCP e especificação de ferramentas.

Isso é descoberta dinâmica, mas convém manter os pés no chão. O modelo não passeia livremente pela rede procurando qualquer ferramenta existente. Ele descobre as capacidades dos servidores aos quais o host decidiu conectá-lo e dentro das permissões atribuídas àquela conexão.

Essa limitação é desejável. Uma IA corporativa não deveria encontrar casualmente um servidor de folha de pagamento, conectar-se a ele e começar a consultar dados. A descoberta ocorre dentro de fronteiras configuradas pela aplicação e pela infraestrutura.

Também existe um custo. Se centenas ou milhares de ferramentas forem enviadas ao modelo de uma só vez, suas descrições ocupam espaço de contexto e podem dificultar a escolha. Sistemas maiores recorrem a catálogos, busca progressiva, agrupamento ou carregamento seletivo das ferramentas relevantes. Padronizar a porta não significa que seja sensato conectar tudo ao mesmo tempo.

Contexto, sessões e uma mudança importante no protocolo

Versões anteriores do MCP estabeleceram sessões no nível do protocolo. Isso tornou comum a explicação de que o MCP seria “stateful”, enquanto uma API HTTP seria “stateless”. Essa comparação nunca foi completamente precisa — uma aplicação HTTP pode manter estado em banco de dados, cookies, tokens ou identificadores de sessão — e ficou ainda menos correta com a evolução do MCP.

A especificação de 28 de julho de 2026 removeu as sessões mantidas pelo próprio protocolo e passou a definir requisições autocontidas e sem estado. O cabeçalho Mcp-Session-Id foi retirado, assim como o antigo processo de inicialização baseado em uma sessão persistente. Quando uma ferramenta precisa continuar um trabalho entre várias chamadas, o servidor pode criar um identificador explícito e devolvê-lo ao cliente. Esse identificador é enviado novamente como argumento nas próximas interações. Mudanças da especificação MCP de julho de 2026.

Pense em um servidor usado para montar uma consulta complexa de banco de dados. Na primeira etapa, ele pode analisar o esquema e devolver um identificador de trabalho. Na etapa seguinte, o cliente envia esse identificador junto com filtros adicionais. O fluxo continua em múltiplos passos, mas o estado não fica escondido em uma sessão implícita do protocolo.

A aplicação hospedeira também mantém o histórico da conversa, os resultados anteriores e as decisões do modelo. Então ainda é possível construir experiências contextuais e processos longos. O que mudou foi o lugar onde esse estado vive e como ele é representado.

Essa escolha ajuda a escalar servidores e reduz dependência de uma conexão específica. Uma requisição pode ser tratada por diferentes instâncias desde que o estado relevante esteja armazenado de maneira acessível ou seja representado por um identificador válido.

Só que a responsabilidade não desapareceu. Agora os desenvolvedores precisam proteger esses identificadores contra roubo, reutilização indevida e confusão entre usuários. Um “handle” de estado não pode virar uma chave informal capaz de abrir o trabalho de outra pessoa.

Host, cliente e servidor: quem faz o quê

A arquitetura do MCP pode ser compreendida por meio de três componentes.

O host é a aplicação de inteligência artificial usada pelo usuário. Pode ser um chatbot, uma IDE, um aplicativo de desktop, um ambiente corporativo ou um agente especializado. O host controla a experiência, administra conexões, aplica políticas, decide quais informações entram no contexto e apresenta confirmações ao usuário.

Dentro do host existe o cliente MCP. Ele implementa o protocolo e conversa com um servidor. Um mesmo host pode manter vários clientes, cada um conectado a um servidor diferente. O cliente cuida da descoberta de capacidades, do envio das chamadas e da interpretação das respostas recebidas.

O servidor MCP expõe ferramentas, recursos ou prompts. Ele pode consultar um banco de dados, acessar arquivos locais, conversar com uma API remota, executar um cálculo ou iniciar um fluxo empresarial. É nessa camada que as particularidades do serviço externo são adaptadas ao contrato MCP.

Um fluxo simples poderia ocorrer assim:

  1. O usuário pede uma lista de pedidos atrasados.
  2. O host envia a solicitação e as ferramentas permitidas ao modelo.
  3. O modelo identifica a ferramenta adequada e produz seus argumentos.
  4. O cliente MCP envia a chamada ao servidor.
  5. O servidor verifica a autorização e consulta o sistema de vendas.
  6. O resultado retorna ao cliente em formato estruturado.
  7. O host decide o que pode ser incorporado à conversa.
  8. O modelo interpreta os dados e prepara a resposta.

O modelo não precisa conhecer a senha do banco nem aprender toda a API do sistema de vendas. Ele conhece a ferramenta que foi disponibilizada. Essa separação é uma das qualidades arquiteturais do MCP.

Mas o host não é um mensageiro passivo. Ele ocupa uma posição sensível. É o host que reúne informações da conversa, resultados de ferramentas e instruções vindas de diferentes fontes. Se ele misturar tudo sem estabelecer limites, pode permitir que um conteúdo malicioso tente influenciar o modelo.

Chaves escondidas não significam segurança automática

Manter chaves de API dentro do servidor MCP é uma prática útil. Em um servidor local iniciado por stdio, por exemplo, as credenciais podem ser fornecidas ao processo por variáveis de ambiente ou por um armazenamento seguro. Em um servidor remoto, podem existir fluxos de autorização compatíveis com OAuth.

Nesse desenho, o modelo não recebe diretamente a chave da API. Ele pede ao servidor que execute uma operação permitida. O servidor utiliza a credencial, obtém o resultado e devolve somente os dados necessários.

Isso reduz a exposição acidental de segredos no histórico da conversa. Ainda assim, não resolve sozinho o problema de segurança. Se o modelo puder chamar uma ferramenta que lê qualquer tabela ou envia qualquer arquivo, esconder a senha não impede o uso abusivo da credencial. A chave continua poderosa; apenas mudou de lugar.

Um servidor seguro precisa trabalhar com menor privilégio possível. Uma ferramenta destinada a consultar estoque não deveria receber permissão para apagar produtos. O usuário que pode ler seus próprios documentos não deve conseguir acessar documentos de outro departamento. Operações destrutivas ou sensíveis precisam de confirmação clara.

A documentação atual recomenda autorização para servidores que acessam dados pessoais, documentos, bancos de dados ou operações administrativas. Também trata de riscos específicos, como passagem indevida de tokens, ataques contra fluxos OAuth, confusão de autoridade em servidores proxy e comprometimento de servidores locais. Guia de autorização MCP e boas práticas de segurança.

Há outro ponto delicado: descrições de ferramentas também precisam ser tratadas como conteúdo não confiável quando vêm de servidores desconhecidos. Um servidor pode afirmar que uma operação é inofensiva, enquanto executa algo muito diferente. Instalar um servidor MCP aleatório equivale, em muitos casos, a instalar software com acesso aos dados e às permissões do usuário.

A popularização do protocolo amplia a superfície de ataque. Quanto mais fácil fica conectar ferramentas, mais importante se torna verificar procedência, código, permissões solicitadas, registros de auditoria e comportamento real do servidor.

Servidores da comunidade, empresariais e agregadores

Nem todo servidor MCP possui o mesmo nível de confiança ou a mesma finalidade.

Os servidores comunitários normalmente são criados por desenvolvedores independentes ou projetos de código aberto. Eles aceleram a experimentação e atendem ferramentas que talvez ainda não tenham integração oficial. São valiosos, mas exigem análise. É necessário verificar manutenção, dependências, permissões, histórico do projeto e maneira como as credenciais são armazenadas.

Os servidores oficiais ou empresariais são desenvolvidos pelo próprio fornecedor do serviço ou por uma organização para uso controlado. Podem oferecer autenticação corporativa, auditoria, gerenciamento centralizado, limites de acesso e compromissos de suporte. “Empresarial” não significa automaticamente seguro, mas existe uma estrutura mais adequada para responsabilização, conformidade e atualização.

Uma empresa também pode construir um servidor interno personalizado. Essa alternativa faz sentido quando existem sistemas legados, regras de negócio específicas ou dados que não podem sair da infraestrutura. Em vez de expor diretamente dezenas de APIs internas, a organização cria ferramentas estreitas, como consultar_laudo, verificar_contrato ou registrar_chamado.

Há ainda os agregadores e gateways MCP. Eles ficam entre os clientes e vários servidores, oferecendo um ponto central de descoberta, autenticação, políticas e observabilidade. Um gateway pode filtrar ferramentas conforme o usuário, registrar chamadas, aplicar limites e impedir que dados de um setor sejam enviados a outro servidor.

Essa centralização facilita a governança. Também cria um alvo valioso. Se o agregador for comprometido ou configurado de maneira incorreta, o invasor pode alcançar várias integrações a partir de um único ponto. A arquitetura precisa prever isolamento, validação de resultados, rotação de credenciais e registros de auditoria que realmente possam ser analisados.

O que o MCP resolve — e o que permanece conosco

O MCP reduz a duplicação de trabalho. Ele oferece uma gramática comum para apresentar capacidades a aplicações de IA, descobrir ferramentas dinamicamente, validar argumentos e devolver resultados estruturados. Também separa melhor o modelo das credenciais e das particularidades de cada API.

Isso já representa uma mudança considerável.

Só que o protocolo não decide quais dados devem ser acessados, quem pode realizar uma operação ou até onde um agente pode agir sozinho. Ele não garante que a descrição de uma ferramenta seja honesta. Não corrige permissões excessivas. Não impede que um servidor vulnerável vaze dados. E não transforma uma API mal projetada em uma boa ferramenta apenas porque ganhou uma camada MCP.

A complexidade não desaparece. Parte dela é transferida das integrações individuais para a construção de servidores, hosts, catálogos, políticas e mecanismos de segurança. A vantagem é que essa complexidade passa a ser organizada em torno de um padrão compartilhado, em vez de ficar espalhada por dezenas de conectores incompatíveis.

Talvez esse seja o ponto mais interessante do MCP. Ele não torna a inteligência artificial verdadeiramente inteligente sobre todos os sistemas. Cria uma maneira mais previsível de dizer ao modelo o que existe, o que pode ser feito e quais dados foram devolvidos.

Na computação, padrões raramente chamam tanta atenção quanto modelos impressionantes ou interfaces bonitas. Mesmo assim, são eles que permitem que ecossistemas inteiros cresçam sem desmoronar sob o peso das próprias integrações.

O MCP está tentando ocupar esse espaço. A porta comum está sendo construída. Agora começa a parte difícil: decidir cuidadosamente o que deixaremos passar por ela.
A história do kernel Linux: do projeto de um estudante ao Linux 7.2

O kernel Linux nasceu como um projeto pessoal, limitado a um tipo específico de computador. Trinta e cinco anos depois, tornou-se a base de servidores, smartphones, supercomputadores, roteadores, automóveis, televisores e infraestruturas de nuvem espalhadas pelo mundo.

Tux, o mascote do Linux, representando a evolução histórica do kernel Linux
Tux tornou-se o mascote do Linux em 1996, quando o kernel já começava a ultrapassar os limites dos computadores pessoais.

Antes do Linux: Unix, GNU e Minix

Para compreender o nascimento do Linux, é necessário voltar aos sistemas Unix, desenvolvidos a partir do final da década de 1960 nos laboratórios Bell. O Unix ajudou a consolidar conceitos que ainda fazem parte dos sistemas operacionais modernos: processos, permissões, arquivos organizados em uma árvore de diretórios, pequenos programas combináveis e uma divisão clara entre o kernel e as ferramentas executadas pelo usuário.

Durante muito tempo, porém, as diferentes versões do Unix estiveram ligadas a universidades ou empresas e eram distribuídas sob licenças restritivas.

Em 1983, Richard Stallman iniciou o Projeto GNU, cujo objetivo era desenvolver um sistema operacional compatível com Unix que pudesse ser usado, estudado, modificado e redistribuído livremente. Diversos componentes fundamentais foram produzidos: compiladores, bibliotecas, interpretadores de comandos, depuradores e utilitários.

Faltava uma peça particularmente complexa: um kernel funcional e suficientemente maduro.

Outro sistema importante para essa história foi o Minix, criado pelo professor Andrew Tanenbaum para fins educacionais. O código do Minix podia ser estudado por alunos interessados em sistemas operacionais, embora sua licença inicial não oferecesse a mesma liberdade que mais tarde seria associada ao Linux.

Foi nesse ambiente que um estudante finlandês chamado Linus Benedict Torvalds começou a trabalhar em seu próprio kernel.

O computador que deu origem ao Linux

No começo de 1991, Linus Torvalds estudava ciência da computação na Universidade de Helsinque. Ele havia comprado um computador equipado com um processador Intel 80386, uma arquitetura que oferecia recursos avançados para a época, como modo protegido, paginação e mecanismos de gerenciamento de memória.

O interesse inicial de Torvalds não era criar uma plataforma mundial nem competir com empresas de software. Ele queria compreender melhor o funcionamento do processador e aproveitar seu novo computador.

Os primeiros experimentos foram relacionados à troca de tarefas e ao acesso ao terminal. Pouco a pouco, o programa cresceu. Linus implementou gerenciamento de memória, processos, acesso a dispositivos e um sistema de arquivos. O que havia começado como um emulador de terminal aproximava-se de um pequeno kernel semelhante ao Unix.

Em julho de 1991, Torvalds já procurava informações sobre as regras POSIX, o conjunto de padrões destinado a manter compatibilidade entre sistemas Unix. Em 25 de agosto daquele ano, publicou uma mensagem no grupo comp.os.minix informando que estava desenvolvendo um sistema operacional livre para computadores 386 e 486.

Na mensagem, apresentou o projeto como um hobby e avisou que ele não seria grande ou profissional como o GNU. A frase tornou-se curiosa porque descrevia justamente o oposto do que aconteceria nas décadas seguintes. As mensagens originais e os comentários de Linus sobre esse período foram preservados em um arquivo histórico sobre o nascimento do Linux.

Linux 0.01: pequeno, limitado e surpreendentemente avançado

A versão 0.01 foi disponibilizada em setembro de 1991. Seu pacote compactado ocupava aproximadamente 71 KB — um tamanho minúsculo quando comparado aos milhões de arquivos e dezenas de milhões de linhas do kernel atual.

O sistema tinha limitações consideráveis:

  • Funcionava apenas em computadores compatíveis com o Intel 386.
  • Dependia do Minix para ser compilado e instalado.
  • Tinha suporte restrito a discos rígidos, teclado, tela e portas seriais.
  • O teclado finlandês estava incorporado ao código.
  • Não possuía comandos completos para montar e desmontar sistemas de arquivos.
  • Não era um sistema adequado para ambientes de produção.
  • Exigia conhecimentos técnicos até mesmo para iniciar.

As notas oficiais do Linux 0.01 deixam claro que aquele software era experimental. Também revelam decisões técnicas relevantes. O kernel utilizava recursos específicos do 386, possuía paginação, segmentação, cópia sob escrita e um sistema de arquivos com capacidade para atender várias tarefas.

A abordagem escolhida era a de um kernel monolítico. Isso significa que componentes como gerenciamento de memória, sistema de arquivos, escalonamento e drivers executavam no espaço privilegiado do kernel.

“Monolítico” não significa necessariamente que o código seja desorganizado ou impossível de ampliar. O Linux evoluiu para uma arquitetura monolítica modular: diversos componentes podem ser separados em módulos e carregados somente quando necessários.

De Freax para Linux

Torvalds teria considerado chamar seu projeto de Freax, uma combinação de “free”, “freak” e a letra X, tradicionalmente associada aos sistemas Unix.

Ari Lemmke, administrador do servidor FTP usado para distribuir os primeiros arquivos, não gostou do nome. Ao criar o diretório público, escolheu “Linux”, combinando Linus e Unix.

O nome permaneceu.

Essa pequena decisão também mostra como o Linux começou a crescer por meio da colaboração. Linus escreveu a base inicial, mas desenvolvedores de diferentes países passaram a testar, corrigir e ampliar o sistema. O correio eletrônico, os grupos de discussão e os servidores FTP funcionaram como a infraestrutura de uma comunidade internacional muito antes da popularização das plataformas modernas de hospedagem de código.

A licença que permitiu o crescimento do projeto

A versão 0.01 não utilizava a licença GNU GPL. Linus havia escrito uma licença própria que permitia a redistribuição do código, mas proibia cobrar pelo software.

Essa restrição apresentava um problema: software livre não significa necessariamente software gratuito. A liberdade de estudar, modificar e redistribuir pode coexistir com a cobrança por cópias, serviços, suporte, integração e manutenção.

Em 1992, o Linux passou a ser distribuído sob a GNU General Public License. A adoção da GPL foi decisiva porque permitiu que pessoas e empresas utilizassem e comercializassem o sistema, desde que respeitassem as obrigações da licença ao distribuir versões modificadas.

O kernel permanece licenciado sob a GPL versão 2. Componentes individuais podem utilizar licenças compatíveis, mas o kernel como conjunto continua sob a GPL-2.0.

Essa escolha jurídica ajudou a criar um espaço incomum: empresas concorrentes poderiam investir em uma infraestrutura comum sem que uma delas tivesse o direito de fechar unilateralmente o código principal.

A discussão entre Linus Torvalds e Andrew Tanenbaum

Uma das primeiras controvérsias do Linux ocorreu em 1992. Andrew Tanenbaum, criador do Minix, criticou publicamente a arquitetura monolítica escolhida por Torvalds.

Tanenbaum defendia os microkernels, nos quais apenas mecanismos essenciais permanecem no núcleo privilegiado. Serviços como drivers e sistemas de arquivos podem ser executados como processos separados. Em teoria, essa divisão melhora o isolamento e reduz os danos provocados por falhas em componentes individuais.

Linus argumentava que sua arquitetura era mais prática e apresentava melhor desempenho no hardware disponível. A discussão também envolveu portabilidade, projeto de sistemas operacionais e a dependência inicial do Linux em relação ao processador 386.

O debate costuma ser recontado como uma disputa simples na qual um lado estava certo e o outro errado. A realidade é mais interessante. Microkernels continuam sendo usados em sistemas nos quais isolamento, verificabilidade e segurança funcional são prioridades. O Linux, por sua vez, demonstrou que um kernel monolítico modular poderia crescer, receber milhares de drivers e funcionar em muitas arquiteturas.

O próprio Linux mudou bastante. Ele deixou de ser rigidamente dependente do 386, ganhou módulos carregáveis, abstrações de hardware, isolamento de processos, namespaces, mecanismos de segurança e suporte a arquiteturas muito diferentes.

Linux 1.0: o projeto experimental torna-se utilizável

O Linux 1.0 foi lançado em 13 de março de 1994. A chegada à versão 1.0 comunicava que o kernel havia atingido um nível razoável de estabilidade e poderia ser usado fora do grupo restrito de pessoas que acompanhavam as versões experimentais.

Entre os recursos desenvolvidos ou amadurecidos durante esse período estavam:

  • Redes TCP/IP.
  • Maior quantidade de drivers.
  • Suporte a SCSI.
  • Integração de recursos de áudio.
  • Melhorias no gerenciamento de memória.
  • Suporte inicial ao formato de executáveis ELF.
  • Sistemas de arquivos mais funcionais.
  • Aprimoramentos no NFS.
  • Suporte a CD-ROM e unidades de fita.
  • Melhorias no escalonador e na criação de processos.

O arquivo oficial de mudanças do Linux 1.0 começa com uma brincadeira sobre a remoção de todos os bugs. O humor já fazia parte da comunicação do projeto, embora a estabilidade de um kernel jamais signifique ausência completa de defeitos.

O Ext2, desenvolvido principalmente por Rémy Card, Theodore Ts’o e Stephen Tweedie, tornou-se uma peça importante dos primeiros sistemas Linux. Ele substituiu sistemas de arquivos mais limitados e permaneceu durante anos como uma escolha comum. Sua estrutura está documentada na documentação oficial do kernel.

Distribuições como Slackware e Debian começaram a transformar o kernel, as ferramentas GNU e outros programas em sistemas instaláveis. Esse ponto é importante: Linux, em sentido técnico, é o kernel. Uma distribuição reúne o kernel, bibliotecas, comandos, instalador, gerenciador de pacotes, ambiente gráfico e aplicações.

Das versões 1.x ao Linux 2.0

O Linux 1.2, lançado em 1995, ampliou o suporte a hardware, redes e sistemas de arquivos. O desenvolvimento também começou a ultrapassar a arquitetura x86, afastando-se da antiga ideia de que o kernel seria inseparável do Intel 386.

Em 1996 chegou o Linux 2.0, um marco para a utilização profissional do sistema. Uma de suas características mais importantes foi o suporte a multiprocessamento simétrico, conhecido como SMP. O kernel passava a trabalhar com máquinas dotadas de mais de um processador.

O suporte a novas arquiteturas também ganhou importância. O Linux começou a aparecer em servidores, estações de trabalho e dispositivos que não se pareciam com o computador pessoal usado por Torvalds em 1991.

Foi durante a era do Linux 2.0 que o pinguim Tux se tornou o mascote do projeto. O desenho original foi criado por Larry Ewing em 1996, usando o programa GIMP. O nome costuma ser interpretado como uma referência a “Torvalds Unix”, embora também lembre a palavra inglesa “tuxedo”, relacionada à aparência de um pinguim.

Linux 2.2: redes, servidores e mais processadores

Lançado em 1999, o Linux 2.2 trouxe avanços no suporte a multiprocessamento, redes, arquiteturas e dispositivos. O kernel tornava-se cada vez mais atraente para servidores de internet e empresas que procuravam uma alternativa aos sistemas Unix comerciais.

A expansão da internet favoreceu o Linux. Servidores web, DNS, correio eletrônico, bancos de dados e compartilhamento de arquivos eram aplicações nas quais estabilidade, automação e acesso ao código tinham grande valor.

O modelo de desenvolvimento também amadurecia. Linus não analisava sozinho cada linha enviada. Mantenedores passaram a cuidar de subsistemas, como redes, armazenamento, arquiteturas, sistemas de arquivos e drivers. Essa estrutura hierárquica permanece fundamental.

Uma alteração normalmente é discutida, revisada e testada dentro de um subsistema. O mantenedor reúne as mudanças consideradas adequadas e as encaminha para os níveis seguintes. A própria documentação sobre envio de patches explica que poucas contribuições são encaminhadas diretamente a Linus Torvalds.

Linux 2.4: USB, desktops, servidores e a participação brasileira

O Linux 2.4 foi lançado em janeiro de 2001. Essa série ampliou o suporte a USB, redes, armazenamento, memória de grande capacidade, multiprocessamento e arquiteturas diferentes. O kernel passou a atender melhor tanto computadores pessoais quanto servidores mais poderosos.

Recursos como Netfilter e iptables fortaleceram sua utilização em roteadores e firewalls. O suporte a dispositivos USB ajudou a aproximar o Linux dos computadores domésticos. Durante a série 2.4, o Ext3 introduziu journaling sobre a base do Ext2, reduzindo o tempo e os riscos da recuperação após desligamentos inesperados.

A história dessa versão possui uma participação brasileira muito importante.

Marcelo Tosatti, o brasileiro responsável pela série estável 2.4

Em novembro de 2001, o gaúcho Marcelo Tosatti tornou-se mantenedor da árvore estável do Linux 2.4. Ele tinha apenas 18 anos.

Tosatti já trabalhava com o kernel na Conectiva, empresa brasileira responsável por uma das primeiras distribuições Linux da América Latina. Alan Cox sugeriu seu nome, e a escolha foi apoiada por Linus Torvalds.

Dizer que Marcelo “desenvolveu o Linux 2.4” seria incorreto. A série já existia e era resultado do trabalho de muitos desenvolvedores. Sua responsabilidade era manter a versão estável: avaliar correções, integrar mudanças seguras, tratar regressões e impedir que novidades arriscadas comprometessem máquinas em produção.

Seu primeiro lançamento como mantenedor foi o Linux 2.4.16, publicado em 26 de novembro de 2001. Uma entrevista com Marcelo Tosatti registra sua escolha e as responsabilidades assumidas.

Esse trabalho tinha um peso enorme. A série 2.4 era usada em servidores, provedores de acesso, equipamentos de rede e sistemas corporativos. Uma correção inadequada poderia afetar milhares de instalações.

A participação de Tosatti também é um capítulo relevante da tecnologia brasileira. A Conectiva não se limitava a traduzir programas. Seus profissionais contribuíam com componentes de baixo nível, empacotamento, internacionalização e desenvolvimento do próprio kernel.

Linux 2.6: a série que pareceu não terminar

O Linux 2.6 foi lançado em dezembro de 2003. Ele representou uma grande modernização na capacidade de escalar, responder rapidamente e atender diferentes categorias de dispositivo.

Entre os destaques da geração 2.6 estavam:

  • Kernel preemptivo, importante para melhorar a resposta do sistema.
  • Novo modelo de dispositivos.
  • Evolução do gerenciamento de energia.
  • Melhor suporte a NUMA e grandes máquinas multiprocessadas.
  • Sysfs e integração com ferramentas como o udev.
  • Novos escalonadores de processos.
  • Expansão do suporte a dispositivos embarcados.
  • Aprimoramentos em segurança, redes e sistemas de arquivos.
  • Virtualização com tecnologias como KVM.
  • Control groups, ou cgroups, essenciais para limitar e organizar recursos.
  • Namespaces, que ajudaram a formar a base dos contêineres modernos.
  • FUSE, permitindo sistemas de arquivos implementados no espaço do usuário.
  • Inotify, usado para monitorar alterações em arquivos e diretórios.

O Linux 2.6 permaneceu como numeração principal durante quase oito anos. Nesse intervalo, o projeto adotou um ciclo mais previsível de desenvolvimento. Em vez de guardar grandes transformações para uma futura versão 2.7, novos recursos passaram a entrar gradualmente em lançamentos regulares.

O escalonador também mudou durante essa longa fase. O Completely Fair Scheduler, ou CFS, entrou no Linux 2.6.23 e substituiu o mecanismo anterior para tarefas comuns. Seu objetivo era aproximar o uso real do processador de uma divisão ideal e justa entre processos. A documentação do CFS descreve esse princípio usando o conceito de tempo de execução virtual.

A controvérsia do BitKeeper e o nascimento do Git

O crescimento do kernel criou um problema de engenharia: como administrar mudanças produzidas por milhares de desenvolvedores?

Em 2002, o projeto começou a usar o BitKeeper, um sistema de controle de versões distribuído, porém proprietário. A escolha gerou críticas dentro da comunidade de software livre. Alguns desenvolvedores consideravam contraditório usar uma ferramenta fechada para construir um dos maiores projetos livres do mundo.

O acesso gratuito oferecido aos desenvolvedores do kernel terminou em 2005, após conflitos envolvendo a engenharia reversa do protocolo do BitKeeper.

Linus Torvalds decidiu criar uma ferramenta própria. Ela deveria ser distribuída, rápida, confiável e capaz de trabalhar com a escala incomum do kernel. O resultado foi o Git.

O Git não nasceu como uma plataforma social ou um serviço de hospedagem. Era um mecanismo para gerenciar objetos, históricos e conjuntos de mudanças de maneira distribuída. Sua criação está diretamente ligada à crise do BitKeeper, conforme relata a história oficial apresentada pelo projeto Git.

A controvérsia terminou produzindo uma das ferramentas mais importantes do desenvolvimento de software moderno.

Linux 3.0: uma mudança de número, não uma reconstrução

O Linux 3.0 foi lançado em julho de 2011, quando o projeto completava vinte anos. A mudança de 2.6.39 para 3.0 não indicava uma ruptura arquitetônica.

Linus considerava a numeração 2.6 longa e pouco prática. O novo número simplificava a identificação das versões e marcava simbolicamente o aniversário do projeto.

Durante a família 3.x, o Linux se fortaleceu em áreas que mudariam a indústria:

  • Android e dispositivos móveis.
  • Computação em nuvem.
  • Virtualização.
  • Contêineres.
  • Arquiteturas ARM.
  • Novos sistemas de arquivos, como Btrfs.
  • Aprimoramentos em cgroups e namespaces.
  • Melhor suporte a gráficos, energia e dispositivos móveis.

O domínio do Linux deixou de estar concentrado em servidores tradicionais. Bilhões de smartphones passaram a executar o kernel por meio do Android, mesmo que muitos usuários não associassem seus aparelhos ao Linux.

Linux 4.0: atualização do kernel em sistemas críticos

O Linux 4.0 chegou em abril de 2015. Assim como a versão 3.0, a troca de numeração não significou que o kernel tivesse sido reescrito.

Um recurso simbólico dessa fase foi a infraestrutura para aplicar determinadas correções ao kernel em execução, base de soluções de live patching. Em ambientes críticos, reiniciar um servidor para cada correção pode ser caro ou operacionalmente difícil. O live patching permite corrigir classes específicas de problemas sem uma reinicialização imediata.

A série 4.x também acompanhou o crescimento de contêineres, plataformas de nuvem, armazenamento flash, redes de alta velocidade, dispositivos ARM e sistemas embarcados.

Tecnologias como eBPF começaram a ultrapassar seu uso original relacionado à filtragem de pacotes. O eBPF evoluiu para uma plataforma capaz de executar programas verificados dentro do kernel, sendo usado em observabilidade, redes, segurança e análise de desempenho.

Linux 5.0: infraestrutura para nuvem, dispositivos e desempenho

Lançado em março de 2019, o Linux 5.0 foi outra alteração numérica motivada principalmente pela conveniência. O kernel continuou seguindo o ciclo regular de integração e estabilização.

Durante a família 5.x, ganharam destaque:

  • io_uring para operações de entrada e saída assíncronas.
  • Expansão do eBPF.
  • WireGuard integrado ao kernel.
  • Melhorias contínuas em AMD, Intel, ARM e RISC-V.
  • Novos drivers para GPUs e aceleradores.
  • Evolução de Ext4, XFS e Btrfs.
  • Aprimoramentos no gerenciamento de energia.
  • Suporte crescente a notebooks, servidores e dispositivos embarcados.
  • Mecanismos usados por plataformas de contêineres e orquestração.

O kernel já não podia ser avaliado apenas pelo desempenho de um computador isolado. Uma alteração aparentemente pequena poderia afetar data centers, redes móveis, clusters de supercomputação, televisores e sistemas industriais.

Linux 6.0: Rust, novas arquiteturas e segurança de memória

O Linux 6.0 foi lançado em outubro de 2022. A mudança de número não representou uma nova arquitetura, mas abriu uma série marcada pela discussão sobre segurança de memória e pela adoção inicial da linguagem Rust.

O suporte inicial à infraestrutura de Rust entrou no Linux 6.1. Isso não significou reescrever o kernel ou abandonar a linguagem C. A intenção era permitir que determinados componentes, sobretudo novos drivers, pudessem aproveitar garantias de segurança oferecidas pela linguagem.

A adoção provocou debates técnicos e culturais. O código em C possui décadas de ferramentas, experiência e convenções. Rust traz um modelo de memória diferente, exige novas abstrações e demanda conhecimento de outra linguagem. Seus defensores apontam a possibilidade de reduzir erros como uso de memória após liberação, acessos inválidos e certas condições de concorrência.

A série 6.x também desenvolveu o sched_ext, uma estrutura que permite implementar políticas de escalonamento extensíveis com auxílio do eBPF. Outras áreas em evolução incluíram io_uring, folios de memória, redes, virtualização confidencial, RISC-V e suporte ao hardware mais recente.

Linux 7.0, 7.1 e 7.2

O Linux 7.0 foi lançado em 12 de abril de 2026. Mais uma vez, não se tratava de uma reconstrução completa. A troca de 6.x para 7.x evitou que a numeração secundária continuasse crescendo indefinidamente.

Segundo o histórico do projeto, os lançamentos 7.0, 7.1 e 7.2 ocorreram com exatamente 63 dias de intervalo: 7.0 em 12 de abril, 7.1 em 14 de junho e 7.2 em 16 de agosto de 2026. A linha do tempo pode ser consultada no Linux Kernel Newbies.

Linux 7.0

Entre as mudanças destacadas no Linux 7.0 estavam:

  • Uma API genérica para informar erros de entrada e saída em arquivos.
  • Monitoramento de integridade para XFS.
  • Melhorias nos filtros do io_uring.
  • Opções voltadas à criação de contêineres com open_tree.
  • Aprimoramentos no mecanismo de swap.
  • Uso padrão de Accurate ECN em redes compatíveis.
  • Trabalho experimental relacionado à árvore de remapeamento do Btrfs.
  • Mecanismos mais seguros para lidar com objetos alocados no kernel.

Esses recursos mostram uma característica do Linux moderno: os avanços raramente cabem em uma única categoria. Um lançamento reúne mudanças em armazenamento, redes, segurança, processadores, drivers, sistemas de arquivos e ferramentas de desenvolvimento.

Linux 7.1

O Linux 7.1 continuou esse processo. Entre seus destaques estavam:

  • Um novo driver para o sistema de arquivos NTFS.
  • Melhorias no swap.
  • Ativação do mecanismo Intel FRED em hardware compatível.
  • Integração entre eBPF e io_uring.
  • Preparação para subescalonadores no sched_ext.
  • Novas opções da chamada clone3.
  • Aprimoramentos para namespaces e criação de contêineres.

A evolução de clone3, namespaces e escalonadores extensíveis é especialmente relevante para data centers. Muitas cargas de trabalho modernas são executadas em contêineres e precisam dividir processadores, memória e dispositivos entre aplicações com perfis muito diferentes.

Linux 7.2

O Linux 7.2 foi lançado em 16 de agosto de 2026 e era a versão principal mais recente na data de elaboração deste artigo. O lançamento pode ser confirmado no arquivo oficial do kernel.

Um de seus destaques é o escalonamento mais consciente da organização dos caches. O kernel pode aproximar tarefas que compartilham dados dentro do mesmo domínio de cache de último nível, reduzindo movimentações desnecessárias e melhorando o aproveitamento do processador em algumas cargas.

O Linux 7.2 também trouxe:

  • Melhorias na recuperação de memória.
  • Uma implementação de swap mais enxuta e eficiente.
  • Suporte a USB4STREAM para transportar fluxos de dados por conexões USB4.
  • Otimizações de desempenho no Btrfs.
  • O novo alvo dm-inlinecrypt para criptografia integrada de dispositivos de bloco.
  • Novas opções relacionadas à família de chamadas openat.
  • Leitura mais rápida de informações em /proc/filesystems e /proc/interrupts.
  • Preparações adicionais para subescalonadores no sched_ext.
  • Atualizações de drivers e suporte a novas gerações de hardware.

A relação detalhada pode ser consultada no resumo técnico do Linux 7.2.

Como um novo kernel é desenvolvido

O kernel atual utiliza um modelo de desenvolvimento contínuo. A versão principal costuma ser lançada a cada nove ou dez semanas.

Após um lançamento, abre-se uma janela de integração de aproximadamente duas semanas. Nesse período, Linus recebe conjuntos de mudanças preparados pelos mantenedores. Encerrada a janela, surgem as versões candidatas, identificadas por -rc1, -rc2 e assim sucessivamente.

As semanas seguintes são voltadas a testes, correções e regressões. Quando a versão é considerada suficientemente estável, ocorre o lançamento oficial. A documentação de versões do kernel explica a divisão entre mainline, stable e longterm.

Isso não significa que todos os usuários devam instalar imediatamente a versão mais recente. Distribuições e empresas costumam manter kernels estáveis ou de longo prazo, aplicando correções de segurança sem incorporar toda novidade disponível na árvore principal.

Quem paga pelo desenvolvimento do Linux?

A imagem romântica de programadores trabalhando apenas nas horas vagas representa parte da origem do Linux, mas não descreve sua realidade industrial.

Muitos desenvolvedores continuam contribuindo de forma independente. Uma parcela significativa das mudanças, porém, é produzida por profissionais pagos por empresas.

Relatórios históricos da Linux Foundation ajudam a dimensionar essa transformação. Em 2011, a fundação estimou que cerca de 75% do desenvolvimento analisado havia sido realizado por profissionais remunerados. Empresas como Red Hat, Intel, IBM, Texas Instruments, Broadcom, Samsung, Oracle e Google apareciam entre as organizações envolvidas. Os números pertencem àquele período e não devem ser apresentados como uma fotografia exata do desenvolvimento atual, mas mostram que a participação empresarial não é recente. Relatório da Linux Foundation de 2011.

Em 2017, outro levantamento contabilizou aproximadamente 15.600 desenvolvedores e mais de 1.400 empresas desde o início do acompanhamento por Git. Intel, Red Hat, Linaro, IBM, Samsung, SUSE, Google, AMD, Renesas e Mellanox estavam entre as principais organizações patrocinadoras de contribuições naquele relatório. Relatório da Linux Foundation de 2017.

O investimento empresarial acontece de várias formas:

  • Salários de engenheiros que trabalham no kernel.
  • Laboratórios de teste e integração contínua.
  • Desenvolvimento de drivers.
  • Correções de segurança.
  • Manutenção de versões de longo prazo.
  • Documentação e revisão de código.
  • Disponibilização antecipada de hardware.
  • Patrocínio de conferências e infraestrutura.
  • Trabalho em compiladores e ferramentas de diagnóstico.

Essas empresas não investem apenas por simpatia ao software livre. Fabricantes precisam que seus processadores, GPUs, controladores e dispositivos funcionem bem. Provedores de nuvem querem melhor desempenho por servidor. Empresas de telecomunicações dependem de redes rápidas e previsíveis. Fabricantes de automóveis e eletrônicos precisam de um kernel adaptável e mantido por muitos anos.

A participação empresarial cria tensões. Cada organização possui interesses próprios, e determinadas mudanças podem favorecer um fabricante ou uma categoria de produto. O processo de revisão pública, a autoridade dos mantenedores e a licença GPL ajudam a impedir que uma única companhia transforme a árvore principal em produto exclusivo.

Linus Torvalds, poder técnico e comportamento controverso

Linus Torvalds é reconhecido por sua competência técnica e por sua capacidade de coordenar um projeto gigantesco. Sua forma de comunicação, porém, tornou-se uma das maiores controvérsias da história do kernel.

Durante anos, Linus publicou respostas agressivas, insultos e críticas pessoais em listas de discussão. Seus defensores argumentavam que o kernel exige padrões elevados e que críticas diretas evitam a integração de código ruim. O problema é que rigor técnico e humilhação pessoal não são a mesma coisa.

Em setembro de 2018, Torvalds reconheceu que seu comportamento havia prejudicado pessoas e anunciou uma pausa para buscar ajuda. O episódio acompanhou a adoção de um Código de Conduta mais explícito.

O Código de Conduta do kernel Linux passou a estabelecer regras contra insultos, ataques pessoais, assédio e outras formas de comportamento inadequado.

A mudança gerou resistência em parte da comunidade. Alguns temiam que as novas normas fossem usadas para controlar discussões técnicas. Outros afirmavam que um ambiente incapaz de distinguir análise de código e agressão pessoal afastava desenvolvedores qualificados.

A pausa de Linus não apagou os episódios anteriores, mas marcou uma mudança importante: o próprio criador do projeto admitiu que a autoridade técnica não justifica qualquer forma de tratamento.

GPLv2, GPLv3 e os limites da abertura

Outra disputa importante envolve a licença do kernel. Quando a GPLv3 foi publicada, surgiram discussões sobre uma possível migração.

Linus Torvalds se opôs à mudança. Uma das divergências estava relacionada às cláusulas da GPLv3 contra a chamada “tivoização”, situação em que um fabricante distribui software livre em um dispositivo, mas utiliza mecanismos técnicos para impedir a execução de versões modificadas pelo usuário.

O kernel continua sob GPLv2. Uma mudança completa também seria juridicamente muito difícil, porque o código possui contribuições protegidas por direitos autorais de milhares de pessoas e organizações.

A discussão revelou uma diferença filosófica. Para alguns integrantes do movimento de software livre, a liberdade do usuário inclui a possibilidade prática de executar uma versão modificada. Para Torvalds, a GPLv2 oferecia um equilíbrio mais adequado entre colaboração, disponibilidade do código e liberdade dos fabricantes para construir produtos.

Drivers proprietários e a relação difícil com fabricantes

O suporte a hardware também produziu conflitos. Durante muitos anos, empresas divulgaram poucos detalhes sobre seus dispositivos ou ofereceram apenas drivers proprietários.

Essa situação cria problemas para o kernel. Um módulo fechado pode deixar de funcionar após mudanças internas, impedir auditoria, dificultar correções de segurança e tornar a investigação de falhas mais complexa.

Linus protagonizou declarações bastante agressivas contra fabricantes que dificultavam o suporte ao Linux. O episódio mais famoso envolveu a NVIDIA em 2012. Embora tenha chamado atenção para um problema real de cooperação técnica, a forma usada por Torvalds também reforçou sua reputação de comunicação hostil.

A relação com fabricantes de hardware melhorou em muitas áreas. Existem drivers abertos para diferentes GPUs, processadores e aceleradores, mas a tensão entre código proprietário, firmware fechado, documentação restrita e desenvolvimento comunitário ainda não desapareceu.

O kernel que quase ninguém vê, mas quase todos utilizam

Um usuário pode passar anos usando Linux sem instalar uma distribuição em seu computador pessoal.

O kernel está presente no Android, em servidores web, roteadores domésticos, televisores, equipamentos industriais, sistemas de entretenimento automotivo, plataformas de nuvem e supercomputadores. Ele aparece em placas minúsculas e em máquinas com milhares de processadores.

Sua força não está apenas no fato de ser gratuito. O Linux reúne quatro características difíceis de combinar:

  • Código-fonte disponível.
  • Grande diversidade de arquiteturas e dispositivos.
  • Processo contínuo de revisão.
  • Investimento de empresas que competem entre si.

Também existem fragilidades. O código acumulado durante décadas é complexo. Mantenedores experientes podem ficar sobrecarregados. Novos desenvolvedores precisam compreender regras técnicas e sociais pouco óbvias. Empresas nem sempre mantêm por tempo suficiente os componentes que introduzem. A pressão por suporte rápido ao novo hardware pode entrar em conflito com estabilidade e qualidade.

O significado do Linux 7.2

Chegar ao Linux 7.2 não significa que o projeto esteja pronto ou próximo de uma forma definitiva. Um kernel nunca fica completo porque o hardware, as ameaças de segurança e as aplicações continuam mudando.

A versão 0.01 precisava do Minix para ser instalada, reconhecia poucos dispositivos e trazia um teclado finlandês incorporado ao código. A versão 7.2 precisa coordenar processadores com arquiteturas híbridas, caches complexos, aceleradores, máquinas virtuais, contêineres, armazenamento criptografado, redes de alta velocidade e cargas de inteligência artificial.

Existe uma continuidade entre esses dois extremos. O projeto ainda é desenvolvido por meio de código compartilhado, revisão técnica e discussões públicas. Linus Torvalds continua ocupando uma posição central, mas o Linux já não pode ser compreendido como a obra de uma única pessoa.

Sua história é a história de uma comunidade que aprendeu a lidar com crescimento, empresas, conflitos, licenças, egos, segurança e mudanças constantes de hardware. É justamente essa combinação imperfeita que transformou o antigo hobby de um estudante em uma das infraestruturas mais importantes da computação moderna.

Apple apresenta M6 de 2 nm e M5 Ultra com quatro dies: o Mac entra de vez na disputa pela IA local

A Apple apresentou dois processadores que ocupam extremos diferentes de sua linha de computadores. O M6 estreia no Mac mini com uma arquitetura de 2 nanômetros voltada ao uso cotidiano, enquanto o M5 Ultra chega ao Mac Studio tentando transformar uma estação compacta em uma máquina capaz de executar modelos massivos de inteligência artificial localmente.

Representação dos processadores Apple M6 e M5 Ultra utilizados no Mac mini e no Mac Studio
O M6 inaugura a fabricação de 2 nanômetros nos chips da Apple, enquanto o M5 Ultra reúne quatro dies e pode trabalhar com até 512 GB de memória unificada.

Os dois lançamentos têm propostas muito diferentes, mas revelam a mesma direção. A Apple não está mais tratando o processamento de inteligência artificial como um recurso complementar. CPU, GPU, Neural Engine, memória e ferramentas de desenvolvimento estão sendo reorganizados para que aplicações de IA sejam executadas diretamente no computador, sem depender o tempo todo de servidores externos.

O M6 representa uma evolução mais ampla, destinada a estudantes, desenvolvedores, usuários domésticos e profissionais que precisam de um desktop pequeno e eficiente. O M5 Ultra pertence a outra categoria. Ele foi projetado para renderização 3D, edição de vídeos pesados, simulações científicas, geração de imagens, desenvolvimento de modelos e execução de grandes modelos de linguagem.

A diferença entre eles não está apenas na quantidade de núcleos. Está na maneira como a Apple pretende dividir o futuro do Mac: computadores menores ganham aceleração neural suficiente para tarefas locais, enquanto o Mac Studio assume o papel de estação de IA, vídeo e computação intensiva.

M6 é o primeiro chip de 2 nanômetros da Apple

A mudança mais visível do M6 está no processo de fabricação. Segundo a empresa, este é o primeiro processador da Apple construído com tecnologia de 2 nanômetros.

O número não deve ser interpretado como uma medida literal de cada transistor. Nas gerações atuais de semicondutores, expressões como 5 nm, 3 nm e 2 nm representam famílias de processos de fabricação, com diferentes níveis de densidade, eficiência e características elétricas.

Na prática, uma tecnologia mais avançada permite colocar mais transistores dentro de uma área limitada. Os engenheiros podem usar esse ganho para aumentar o desempenho, reduzir o consumo, acrescentar novos blocos de processamento ou equilibrar essas três possibilidades.

A Apple afirma que o processo de 2 nm proporciona ao M6 um avanço simultâneo em desempenho e eficiência energética. É uma afirmação plausível considerando a evolução da fabricação, mas a dimensão real desse ganho dependerá de medições independentes de consumo, temperatura e desempenho sustentado.

Um chip pode ser muito rápido durante alguns segundos e reduzir sua frequência quando aquece. Também pode apresentar excelente eficiência em determinada carga e comportamento diferente em outra. Esses detalhes só ficam claros quando os computadores chegam aos usuários e passam por testes fora do ambiente controlado da fabricante.

Mesmo assim, a estreia dos 2 nm é significativa. Ela dá à Apple mais espaço para ampliar partes importantes do sistema sem transformar o Mac mini em uma máquina maior ou mais difícil de resfriar.

Uma CPU de 12 núcleos com nova divisão de tarefas

O M6 traz uma CPU com 12 núcleos, dois a mais que a geração anterior. A organização interna chama atenção: são dois “super cores”, quatro núcleos de desempenho e seis núcleos de eficiência.

Os núcleos de eficiência cuidam de operações cotidianas e tarefas em segundo plano consumindo menos energia. Os núcleos de desempenho entram quando o trabalho exige mais capacidade de processamento. Os dois super cores assumem as tarefas mais sensíveis à velocidade de execução individual.

Essa estrutura representa uma evolução da arquitetura híbrida que a Apple já utiliza há várias gerações. Em vez de tratar todos os núcleos da mesma forma, o sistema distribui o trabalho conforme a necessidade. Não faz sentido ativar uma unidade muito poderosa para verificar notificações ou sincronizar pequenos arquivos. Da mesma maneira, compilar um projeto grande ou processar uma imagem complexa exige recursos que os núcleos econômicos não entregariam na mesma velocidade.

Segundo os números divulgados no comunicado oficial do M6 e do M5 Ultra, o novo processador oferece desempenho multithread de até 1,2 vez o M5 e até 2,4 vezes o M1. A empresa também afirma possuir o núcleo de CPU mais rápido do mundo em desempenho single-thread.

Essa última frase precisa ser lida como uma alegação de fabricante. A Apple informa que realizou seus testes em agosto de 2026, utilizando sistemas comerciais concorrentes e benchmarks selecionados. Ainda não há, no momento do anúncio, uma bateria ampla de avaliações independentes que permita comparar o M6 com todas as arquiteturas atuais em diferentes sistemas, aplicações e limites de energia.

O desempenho single-thread continua importante porque muitos processos não conseguem distribuir perfeitamente o trabalho entre dezenas de núcleos. Partes de compiladores, navegadores, ferramentas de edição e interfaces dependem da velocidade de uma sequência principal de instruções. É isso que costuma produzir a sensação de resposta imediata ao abrir programas, manipular projetos ou realizar operações curtas.

Já o ganho multithread aparece com mais clareza na compilação de código, exportação de arquivos, indexação, renderização e outras tarefas capazes de utilizar vários núcleos ao mesmo tempo.

Dual Neural Engine: dois blocos dedicados à IA

O M6 também estreia o que a Apple chama de Dual 16-core Neural Engine. Em termos simples, o chip possui dois motores neurais com 16 núcleos cada, voltados à execução de operações comuns em redes neurais.

O Neural Engine surgiu nos chips da Apple inicialmente ligado a recursos como reconhecimento de imagens, fotografia computacional, processamento de voz e aprendizado de máquina. Com a expansão dos modelos generativos, esse bloco ganhou outra importância.

Agora ele precisa lidar com tarefas como:

  • execução de modelos locais;
  • análise e classificação de conteúdo;
  • transcrição;
  • geração e transformação de imagens;
  • compreensão de linguagem;
  • recursos da Apple Intelligence;
  • operações realizadas por agentes de IA;
  • inferência de redes neurais incorporadas aos aplicativos.

A Apple afirma que o novo conjunto pode entregar até duas vezes o pico de capacidade computacional das gerações anteriores. Os frameworks do sistema conseguem utilizar os dois motores ao mesmo tempo, desde que o aplicativo e a carga tenham sido preparados para isso.

Esse detalhe importa. Dobrar um bloco de hardware não significa que todo aplicativo ficará duas vezes mais rápido automaticamente. O modelo precisa utilizar operações compatíveis, a tarefa precisa ser distribuída de maneira eficiente e o software deve conseguir alimentar os dois motores sem criar gargalos em outras partes do sistema.

Em alguns trabalhos, a limitação estará na GPU. Em outros, na largura de banda da memória. Também existem modelos que executam determinadas operações na CPU porque elas não se adaptam bem ao Neural Engine.

A arquitetura de IA da Apple está se tornando heterogênea. Isso significa que uma mesma carga pode ser dividida entre CPU, GPU e Neural Engine. O macOS e os frameworks da empresa tentam decidir qual parte do processador é mais adequada para cada operação.

Para o desenvolvedor, o ganho depende menos de “programar diretamente os 32 núcleos neurais” e mais de utilizar ferramentas que saibam aproveitar a arquitetura.

A GPU do M6 também ganhou aceleradores neurais

O M6 possui uma GPU de 12 núcleos, novamente dois a mais que o M5. Cada núcleo gráfico inclui um Neural Accelerator dedicado.

Essa aproximação entre computação gráfica e inteligência artificial acompanha uma transformação vista em toda a indústria. GPUs sempre foram boas em executar grandes quantidades de operações paralelas. As redes neurais se beneficiam justamente desse tipo de cálculo, especialmente multiplicações de matrizes realizadas repetidamente.

A presença de aceleradores especializados dentro dos núcleos da GPU busca melhorar esse trabalho sem depender exclusivamente do Neural Engine. Modelos generativos, ferramentas de imagem, aplicações de vídeo e grandes modelos de linguagem podem dividir suas operações entre diferentes unidades.

Segundo a Apple, o M6 apresenta um aumento próximo de 30% no pico de computação de IA pela GPU em comparação com o M5 e supera em mais de oito vezes a capacidade do M1 nessa métrica específica.

“Pico de computação” não é sinônimo de desempenho final do aplicativo. Trata-se de uma medida da capacidade teórica ou máxima de determinado bloco. O resultado percebido pelo usuário depende do modelo, da precisão numérica utilizada, do tamanho do contexto, do formato dos pesos, da memória disponível e da otimização do software.

Essa distinção ficou ainda mais necessária com a explosão das comparações de IA. Um computador pode ter excelente capacidade matemática e, mesmo assim, apresentar resultados medianos em um modelo mal otimizado. Outro pode ter números teóricos menores, mas contar com bibliotecas mais maduras e executar a mesma tarefa com maior eficiência.

O anúncio fornece uma direção. Os testes práticos dirão o tamanho do avanço.

Gráficos, jogos e ray tracing

O foco em IA não eliminou a função tradicional da GPU. O M6 recebe uma arquitetura atualizada de shaders, melhorias no Dynamic Caching e aceleração de ray tracing por hardware.

O Dynamic Caching é uma tecnologia utilizada para ajustar dinamicamente a quantidade de memória local destinada às tarefas da GPU. Em arquiteturas mais tradicionais, uma parte dos recursos pode acabar reservada sem ser totalmente utilizada. A proposta é realizar essa alocação de forma mais precisa, reduzindo desperdícios e aumentando o aproveitamento do chip.

A Apple também declara um aumento de 50% na taxa de processamento de geometria. Esse ganho pode ajudar em cenas tridimensionais complexas, jogos, modelagem 3D, visualização arquitetônica e aplicações que trabalham com muitos objetos.

O ray tracing simula o comportamento da luz para produzir reflexos, sombras e iluminação mais realistas. É uma técnica computacionalmente pesada, por isso a aceleração em hardware faz tanta diferença.

Ainda existe uma questão que a especificação do processador não resolve: disponibilidade de jogos. A Apple vem fortalecendo o Metal e aproximando o Mac de títulos mais exigentes, mas desempenho de GPU, por si só, não cria um catálogo. Desenvolvedores precisam portar, testar e manter seus jogos no macOS.

Para criação de conteúdo, o cenário costuma ser mais favorável. Aplicações de edição, renderização e produção audiovisual já aproveitam amplamente os recursos do Apple silicon.

Memória unificada mais rápida, mas limitada a 32 GB

O M6 alcança até 170 GB/s de largura de banda de memória, aproximadamente 10% acima do M5 e 2,5 vezes a largura de banda oferecida pelo M1, segundo a Apple. A capacidade máxima, porém, permanece em 32 GB no Mac mini equipado com esse chip.

Na arquitetura de memória unificada, CPU, GPU e Neural Engine acessam o mesmo conjunto de memória. Isso reduz a necessidade de copiar dados entre a memória principal e uma memória gráfica separada.

A ideia é especialmente útil em inteligência artificial. Os pesos de um modelo podem ser acessados pelos diferentes componentes do chip sem tantas movimentações intermediárias. O resultado potencial é menor latência, melhor eficiência e aproveitamento mais flexível da capacidade instalada.

Só que 32 GB ainda impõem limites claros.

Essa quantidade é confortável para atividades domésticas, desenvolvimento de software, edição de imagens, alguns projetos de vídeo e modelos locais menores. Já modelos de linguagem maiores, contextos muito extensos e geração avançada podem consumir rapidamente toda a memória disponível.

O M6 não tenta resolver o segmento extremo. Ele oferece uma base eficiente para IA local de uso cotidiano. Quem precisa carregar centenas de gigabytes de pesos entra no território do M5 Ultra.

M5 Ultra estreia uma arquitetura com quatro dies

O M5 Ultra é descrito pela Apple como o processador mais poderoso já criado pela empresa. Seu principal diferencial é a arquitetura de quatro dies, a primeira desse tipo em um chip da série M.

Um die é a parte física de silício que contém os componentes do processador. Fabricar um único chip gigantesco pode ser caro e difícil, pois qualquer defeito na produção compromete uma área maior. Uma alternativa é combinar vários dies menores por meio de conexões de alta velocidade.

No M5 Ultra, a Apple utiliza a tecnologia UltraFusion para conectar dois conjuntos M5 Max, cada um já formado por dois dies. O resultado é um sistema com quatro partes físicas trabalhando como um único processador lógico.

A comunicação entre os dies é decisiva. Se a conexão for lenta, o processador pode perder desempenho enquanto uma parte espera dados da outra. A Apple afirma ter elevado a largura de banda entre os dies para mais de 4,4 TB/s e aumentado a densidade das conexões em mais de seis vezes.

Esses números buscam permitir que os quatro dies compartilhem informações com baixa latência. Para o software, a intenção é que a estrutura se comporte como um grande sistema integrado, sem exigir que cada aplicativo seja refeito para gerenciar manualmente quatro chips separados.

É uma solução tecnicamente ambiciosa. Também será uma das partes mais interessantes dos futuros testes do Mac Studio: cargas reais mostrarão até que ponto o sistema consegue escalar entre todos os dies sem sofrer com sincronização, temperatura ou distribuição desigual do trabalho.

Até 36 núcleos de CPU no Mac Studio

O M5 Ultra pode ser configurado com uma CPU de até 36 núcleos, divididos entre 12 super cores e 24 núcleos de desempenho. Diferentemente do M6, não há núcleos de eficiência nessa configuração máxima divulgada.

Isso deixa evidente a prioridade. O M5 Ultra não foi construído para economizar cada pequena parcela de energia durante tarefas leves. Ele foi pensado para permanecer sob carga intensa, lidando com projetos nos quais terminar o trabalho mais cedo pode ser mais importante do que reduzir o consumo instantâneo.

A Apple aponta desempenho single-thread até 1,25 vez superior ao M3 Ultra e desempenho multithread até 1,3 vez maior. As comparações foram realizadas pela própria empresa com unidades de pré-produção do novo Mac Studio.

Um avanço de 30% em cargas multithread pode parecer menos dramático do que os números de IA apresentados no mesmo anúncio. A razão é que o foco desta geração está espalhado por várias áreas: interconexão dos dies, GPU, aceleradores neurais, memória, mecanismos de vídeo e execução local de modelos.

O M5 Ultra não é apenas uma CPU maior. Ele é uma plataforma de computação heterogênea.

GPU de até 80 núcleos e aceleração neural

A GPU do M5 Ultra chega a 80 núcleos, cada um equipado com um Neural Accelerator. Segundo o comunicado, a capacidade máxima de computação da GPU para IA pode ser até 4,5 vezes a do M3 Ultra e mais de seis vezes a do M1 Ultra.

Em uma comparação distinta de desempenho no Mac Studio, a empresa fala em ganhos de até 4,3 vezes sobre o M3 Ultra em determinados trabalhos de IA. A diferença entre os números ocorre porque “pico de computação” e “desempenho medido em uma aplicação” não são a mesma coisa.

A GPU incorpora shaders atualizados, Dynamic Caching de segunda geração, mesh shading acelerado e ray tracing de terceira geração. A Apple promete gráficos até 40% mais rápidos que os do M3 Ultra em sua comparação de arquitetura, enquanto a apresentação do novo Mac Studio menciona ganhos de até 1,8 vez em cargas selecionadas.

É um processador voltado a trabalhos bastante específicos:

  • renderização tridimensional;
  • efeitos visuais;
  • geração de imagens e vídeos;
  • treinamento ou ajuste de modelos;
  • simulações científicas;
  • visualização de grandes conjuntos de dados;
  • inferência de modelos generativos;
  • desenvolvimento de jogos;
  • edição de vídeo em alta resolução.

Para um usuário que navega na internet, edita documentos e ocasionalmente trabalha com imagens, grande parte dessa capacidade ficaria parada. O M5 Ultra faz sentido quando cada minuto de renderização, compilação ou processamento tem valor econômico.

Os 512 GB de memória são uma parte central do projeto

O componente mais impressionante do M5 Ultra talvez não seja a CPU nem a GPU. É a possibilidade de configurar o Mac Studio com até 512 GB de memória unificada e acessar essa memória com largura de banda de 1,2 TB/s.

A largura de banda é 50% superior à do M3 Ultra, de acordo com a Apple. Ela representa a quantidade de dados que o sistema consegue movimentar por segundo entre a memória e as unidades de processamento.

Grandes modelos de linguagem são particularmente sensíveis a esse fator. Durante a inferência, o computador precisa acessar repetidamente os pesos do modelo. Quando a largura de banda não acompanha a capacidade da GPU, os núcleos ficam esperando pelos dados.

Os 512 GB também permitem manter modelos muito grandes inteiramente na memória. A Apple afirma que o sistema pode executar localmente LLMs com centenas de bilhões de parâmetros, desde que sejam utilizados formatos e níveis de quantização compatíveis com a capacidade disponível.

Isso não significa que qualquer modelo desse tamanho será executado em sua precisão original ou terá o mesmo desempenho de um grande data center. Modelos podem exigir quantização para reduzir o consumo de memória. O tamanho do contexto também ocupa espaço, assim como o próprio sistema operacional e os aplicativos.

Mesmo com essas ressalvas, trata-se de uma capacidade incomum em um computador de mesa compacto. Muitas GPUs dedicadas de alto desempenho oferecem memória muito mais limitada. Servidores conseguem superar essa quantidade combinando várias placas, mas o custo, o consumo e a complexidade aumentam rapidamente.

A memória unificada cria uma característica interessante: os 512 GB não estão presos exclusivamente à CPU ou à GPU. O sistema pode distribuir seu uso conforme a carga. Para pesquisa local, prototipagem e trabalho com modelos privados, isso pode ser mais valioso do que uma simples comparação de núcleos.

Inteligência artificial local não é apenas uma questão de velocidade

A Apple associa os novos processadores à possibilidade de executar modelos de IA sem enviar dados continuamente para a nuvem.

Essa abordagem oferece algumas vantagens. Informações sensíveis podem permanecer no computador. A aplicação continua funcionando mesmo com conectividade limitada. O usuário não precisa pagar por cada token processado por um serviço remoto. A latência também pode diminuir, especialmente em tarefas interativas.

Existem limitações.

Modelos em nuvem podem utilizar grandes agrupamentos de GPUs, receber atualizações frequentes e atender cargas que seriam inviáveis em um computador pessoal. Executar tudo localmente exige armazenamento, memória, energia e capacidade de manutenção. Alguns modelos sequer possuem pesos abertos para instalação.

A tendência mais provável é híbrida. Tarefas privadas, rápidas ou repetitivas serão processadas no próprio Mac. Operações muito grandes ou dependentes de modelos fechados continuarão utilizando servidores.

O M6 e o M5 Ultra cobrem dois pontos dessa arquitetura. O M6 oferece IA local integrada ao computador cotidiano. O M5 Ultra tenta colocar uma parcela da computação antes restrita a servidores dentro de um desktop profissional.

Um mecanismo de mídia construído para produção audiovisual

O M5 Ultra também recebe um Media Engine mais poderoso, com aceleração dedicada para H.264, HEVC, ProRes, ProRes RAW e decodificação AV1.

Na configuração divulgada pela Apple, o chip possui dois mecanismos de decodificação de vídeo, quatro mecanismos de codificação e quatro unidades ProRes de codificação e decodificação. A empresa diz que o Mac Studio consegue reproduzir simultaneamente até 33 fluxos de vídeo ProRes 422 em resolução 8K e 30 quadros por segundo.

Esse tipo de aceleração é diferente de executar toda a operação na CPU. Blocos especializados conseguem processar codecs com mais eficiência, liberando CPU e GPU para efeitos, composição, correção de cor e outras partes do projeto.

Para editores de vídeo, estúdios e profissionais de efeitos visuais, o Media Engine pode ter impacto mais concreto do que o discurso sobre IA. Um projeto com várias câmeras, arquivos de alta resolução e camadas de efeitos coloca pressão sobre memória, armazenamento, decodificação e renderização ao mesmo tempo.

A página de especificações do Mac Studio confirma opções com CPU de 30 ou 36 núcleos, GPU de 64 ou 80 núcleos, Neural Engine de 32 núcleos e configurações de memória que chegam a 512 GB.

Desenvolvedores terão que aproveitar CPU, GPU e Neural Engine

Hardware especializado só apresenta bons resultados quando existem ferramentas capazes de utilizá-lo.

A Apple está concentrando esse trabalho em tecnologias como Core AI, Core ML, Metal, MLX e Xcode. Cada uma atua em uma parte diferente do processo de criação e execução de aplicações inteligentes.

O Core ML permite integrar modelos de aprendizado de máquina aos aplicativos. O Metal oferece acesso à computação da GPU. O MLX é um framework aberto e otimizado para Apple silicon, usado em experimentação, treinamento e inferência. Já o novo Core AI procura organizar a execução de modelos entre memória unificada, CPU, GPU e Neural Engine.

A proposta é evitar que o desenvolvedor precise administrar manualmente cada unidade de processamento. Os frameworks analisam as operações e tentam utilizar o componente mais adequado.

A Apple também permite que aplicativos acessem seus Foundation Models e recursos da Apple Intelligence por meio de ferramentas como App Intents. Desenvolvedores continuam podendo incorporar modelos próprios, o que é indispensável para empresas que trabalham com informações privadas ou sistemas especializados.

O benefício será maior nos aplicativos que adotarem essas APIs. Softwares antigos ou desenvolvidos sem otimização específica podem utilizar apenas uma pequena parte do novo hardware.

E existe a questão da compatibilidade. Nem todo modelo criado para CUDA ou preparado para GPUs de outros fabricantes será transportado imediatamente para o ecossistema da Apple. Ferramentas como MLX reduzem essa barreira, mas o ecossistema de software ainda pesa tanto quanto o silício.

Mac mini e Mac Studio deixam de disputar exatamente o mesmo usuário

O novo Mac mini com M6 procura oferecer desempenho elevado em uma máquina compacta, com 16 GB de memória na configuração inicial e possibilidade de chegar a 32 GB. Ele atende programação, produtividade, edição, desenvolvimento e experimentação com IA local.

A Apple também o posiciona como um dispositivo que pode permanecer ligado executando agentes de inteligência artificial. Esse é um uso relativamente novo para um computador doméstico: uma pequena máquina dedicada a automações, análise de documentos, geração de conteúdo, monitoramento ou serviços locais.

Já o Mac Studio com M5 Ultra funciona como estação profissional. Seu público não está apenas procurando um computador rápido. Está procurando capacidade para manter conjuntos enormes de dados na memória, processar vídeo de alta resolução ou executar modelos que não cabem em equipamentos convencionais.

A diferença aparece até na escala da conectividade. O novo Mac Studio adota Thunderbolt 5 e pode utilizar RDMA para formar grupos de várias máquinas. A Apple afirma que um cluster de quatro Mac Studio pode alcançar até três vezes o desempenho de inferência de uma única unidade em cargas selecionadas.

Isso não transforma o Mac Studio em substituto universal de um data center. Cria, porém, uma opção intermediária interessante entre um computador pessoal e uma infraestrutura especializada de servidores.

Os números são grandes, mas ainda são números da Apple

Quase todas as comparações apresentadas até agora foram produzidas pela própria fabricante em computadores de pré-produção, utilizando sistemas e cargas selecionadas.

Isso não invalida os resultados. A Apple informa a configuração das máquinas comparadas e descreve que utilizou benchmarks e aplicações específicas. O cuidado necessário está na interpretação.

“Até 4,5 vezes mais computação de IA” não significa que qualquer modelo ficará 4,5 vezes mais rápido. “Até 40% mais desempenho gráfico” não garante a mesma diferença em todos os jogos. “O núcleo mais rápido do mundo” depende do conjunto de sistemas, do benchmark e dos limites energéticos usados na comparação.

Também será necessário observar:

  • desempenho após vários minutos de carga;
  • temperatura e ruído;
  • consumo na tomada;
  • escalabilidade entre os quatro dies;
  • eficiência do Dual Neural Engine;
  • compatibilidade dos modelos;
  • desempenho com diferentes quantizações;
  • velocidade real de geração de tokens;
  • comportamento com toda a memória ocupada;
  • suporte dos aplicativos profissionais.

Os lançamentos foram anunciados em 25 de agosto de 2026, e a disponibilidade dos novos Mac mini e Mac Studio está prevista para 22 de setembro. Até que as unidades comerciais sejam analisadas por veículos e laboratórios independentes, o material oficial deve ser entendido como uma apresentação técnica acompanhada de marketing.

A mudança mais importante não está na litografia

Os 2 nanômetros do M6 são importantes. A arquitetura com quatro dies do M5 Ultra também. Mesmo assim, o aspecto mais revelador do anúncio é a distribuição do processamento neural por todo o chip.

A Apple não depende apenas de um Neural Engine maior. Ela adiciona Neural Accelerators aos núcleos da GPU, amplia a memória, aumenta a largura de banda, desenvolve novos frameworks e prepara o sistema para movimentar trabalhos entre diferentes unidades.

O computador deixa de ter “um componente de IA” isolado. A inteligência artificial passa a influenciar o desenho completo do processador.

Esse movimento também aparece na quantidade de memória do M5 Ultra. Durante anos, a discussão sobre computadores pessoais ficou concentrada em CPU e GPU. Modelos generativos trouxeram a memória novamente para o centro do projeto, pois não adianta possuir dezenas de núcleos se os pesos do modelo não cabem no sistema ou chegam lentamente às unidades de cálculo.

O M6 procura tornar a IA local uma função normal de um Mac compacto. O M5 Ultra leva a mesma ideia ao limite, com quatro dies, GPU de 80 núcleos, 512 GB de memória e largura de banda de 1,2 TB/s.

Ainda não sabemos se a geração cumprirá todas as promessas de desempenho. Isso depende de testes, aplicativos e de como os desenvolvedores responderão às novas ferramentas. O rumo, porém, ficou claro: para a Apple, o próximo ciclo dos computadores não será definido apenas por máquinas mais rápidas, mas por quanto processamento inteligente elas conseguem realizar sem sair da mesa do usuário.

COBOL: a linguagem de 1959 que ainda movimenta bancos, governos e grandes empresas

Quando uma transferência bancária é processada, uma folha de pagamento é calculada ou uma apólice de seguro é atualizada, existe uma possibilidade real de que alguma etapa dessa operação passe por um programa escrito em COBOL. A linguagem nasceu antes da internet, dos computadores pessoais e dos bancos de dados relacionais, mas continua presente em sistemas que não podem simplesmente parar para serem reconstruídos.

Representação de um sistema COBOL conectado a mainframe, banco de dados, aplicações web, APIs e serviços em nuvem
O COBOL raramente trabalha sozinho: ele faz parte de um ecossistema que reúne mainframes, bancos de dados, processamento em lote, mensageria, APIs e aplicações modernas.

Essa longevidade costuma produzir duas interpretações opostas. Para alguns, o COBOL é uma relíquia que deveria ter desaparecido há décadas. Para outros, é uma tecnologia tão confiável que não existe motivo para substituí-la. As duas visões simplificam um problema muito mais interessante.

O COBOL não continua em uso apenas porque empresas resistem à mudança. Ele permanece porque décadas de regras comerciais, cálculos financeiros, exceções operacionais e exigências regulatórias foram incorporadas aos programas. Em muitos casos, o código representa uma parte da memória institucional da organização.

O que é COBOL?

COBOL é a sigla para Common Business-Oriented Language, ou Linguagem Comum Orientada a Negócios. Trata-se de uma linguagem compilada de alto nível, criada especificamente para aplicações administrativas e processamento de dados empresariais.

Seu objetivo nunca foi controlar foguetes, desenvolver jogos ou realizar cálculos científicos avançados. O COBOL foi pensado para tarefas como:

  • processar folhas de pagamento;
  • calcular juros e parcelas;
  • atualizar saldos;
  • emitir faturas;
  • consolidar movimentações financeiras;
  • administrar apólices de seguro;
  • controlar estoques;
  • gerar relatórios;
  • processar grandes arquivos de registros;
  • validar operações segundo regras de negócio.

Uma de suas características mais conhecidas é a sintaxe relativamente próxima do inglês. Um programa simples pode conter instruções como MOVE, ADD, SUBTRACT, COMPUTE, READ, WRITE, PERFORM e DISPLAY.

Um exemplo básico seria:

       IDENTIFICATION DIVISION.
       PROGRAM-ID. CALCULA-SALDO.

       DATA DIVISION.
       WORKING-STORAGE SECTION.
       01 SALDO-ATUAL    PIC S9(9)V99 COMP-3.
       01 VALOR-DEPOSITO PIC S9(9)V99 COMP-3.

       PROCEDURE DIVISION.
           ADD VALOR-DEPOSITO TO SALDO-ATUAL
           DISPLAY "NOVO SALDO: " SALDO-ATUAL
           STOP RUN.

A aparência pode parecer incomum para quem começou a programar em Python, JavaScript ou Java. Ainda assim, o propósito do código é razoavelmente legível: adicionar o valor de um depósito ao saldo atual.

A linguagem também se destaca pelo tratamento de números decimais de ponto fixo. Isso é importante em sistemas financeiros, nos quais erros de arredondamento podem produzir diferenças contábeis. A IBM descreve o COBOL como especialmente adequado ao processamento confiável e volumoso de dados comerciais, incluindo arquivos sequenciais, indexados e relativos.

Uma linguagem criada para resolver a fragmentação

No final da década de 1950, os computadores eram equipamentos grandes, caros e profundamente incompatíveis entre si. Cada fabricante possuía arquiteturas, sistemas e linguagens próprias. Um programa desenvolvido para uma máquina geralmente precisava ser reescrito para funcionar em outra.

Essa dependência preocupava governos e grandes empresas. Trocar de fornecedor não significava apenas comprar um computador novo: podia exigir a reconstrução de todo o conjunto de programas administrativos.

Em 1959, representantes do governo dos Estados Unidos, fabricantes de computadores e grandes organizações formaram o Conference on Data Systems Languages, conhecido como CODASYL. O grupo buscava criar uma linguagem comum, voltada ao processamento de dados comerciais e menos dependente de um fabricante específico.

Grace Hopper teve influência decisiva nesse processo por meio de seu trabalho com compiladores e com o FLOW-MATIC, uma linguagem que permitia descrever operações comerciais com instruções semelhantes ao inglês. É impreciso, porém, afirmar que Hopper criou o COBOL sozinha. A linguagem foi resultado do trabalho coletivo de comitês técnicos, instituições públicas e empresas.

A primeira especificação foi apresentada em 1960. O COBOL recebeu revisões sucessivas e foi padronizado pelo ANSI em 1968. Vieram depois versões como COBOL-74, COBOL-85, COBOL 2002, COBOL 2014 e COBOL 2023. A atual norma publicada é a ISO/IEC 1989:2023, que define a sintaxe e a semântica da linguagem e busca preservar seu grau de independência entre diferentes sistemas de processamento.

O fato de existir uma especificação publicada em 2023 — e de uma nova revisão estar em desenvolvimento — mostra que o COBOL não é apenas um artefato histórico congelado em 1959.

A importância dos mainframes

Embora possa ser executado em outros ambientes, o COBOL tornou-se fortemente associado aos mainframes. Esses computadores foram construídos para processar grandes volumes de dados com disponibilidade, segurança, controle de acesso e previsibilidade operacional.

A família IBM System/360, apresentada em 1964, teve papel importante nessa expansão. A proposta de uma arquitetura compatível entre diferentes modelos permitia que empresas ampliassem sua capacidade de processamento sem abandonar todo o software já desenvolvido.

O mainframe transformou-se na base de sistemas bancários, seguradoras, empresas aéreas, governos, indústrias, redes varejistas e grandes processadores de pagamentos. O COBOL encontrou nesse ambiente um espaço ideal: processamento de arquivos extensos, cálculos comerciais, tarefas repetitivas e milhões de transações que exigiam consistência.

Ainda hoje, organizações brasileiras mantêm operações importantes em mainframes. Um caso documentado é o do Banco do Brasil, que utiliza tecnologias Db2 for z/OS e IBM Z para disponibilizar dados corporativos e sustentar consultas realizadas por milhares de painéis internos. O Banco de Brasília também mantém uma infraestrutura baseada em IBM Z, z/OS, CICS e Db2.

Esses exemplos não significam que todo o sistema esteja escrito em COBOL. Eles demonstram que a plataforma na qual muitas aplicações COBOL tradicionalmente operam continua presente em instituições brasileiras relevantes.

COBOL nunca foi uma tecnologia isolada

É comum imaginar um programador escrevendo COBOL em uma tela preta e controlando sozinho todo o sistema. Na prática, aplicações corporativas são formadas por várias tecnologias interdependentes.

Aprender a sintaxe do COBOL é apenas a primeira parte. Para compreender uma aplicação real, o profissional normalmente precisa conhecer componentes de execução, armazenamento, segurança, comunicação e automação.

JCL e o processamento em lote

O Job Control Language, ou JCL, é usado no ambiente z/OS para descrever trabalhos que serão executados pelo computador.

O JCL não substitui o COBOL. Sua função é informar ao sistema qual programa executar, quais arquivos serão utilizados, onde os resultados deverão ser gravados, quais recursos serão necessários e o que fazer em determinadas condições.

Imagine o fechamento noturno de um banco. Um conjunto de tarefas pode precisar:

  1. receber os movimentos realizados durante o dia;
  2. validar os registros;
  3. calcular juros;
  4. atualizar saldos;
  5. gerar arquivos contábeis;
  6. produzir relatórios;
  7. arquivar os resultados;
  8. liberar o próximo ciclo de processamento.

Os programas responsáveis pelos cálculos podem estar em COBOL. O JCL organiza e inicia sua execução.

Esse processamento em lote continua relevante porque permite tratar enormes quantidades de dados de maneira planejada e controlada. Para quem está acostumado apenas a APIs e aplicações web, entender uma janela de processamento noturno exige uma mudança de perspectiva.

VSAM e os arquivos corporativos

Antes de bancos de dados relacionais se tornarem comuns, muitas aplicações armazenavam informações em arquivos. No ecossistema IBM, o VSAM tornou-se uma tecnologia importante para organizar e acessar conjuntos de dados sequenciais ou indexados.

Sistemas COBOL podem ler, alterar e gravar registros VSAM. É possível localizar uma conta por uma chave, percorrer registros em sequência ou produzir um novo arquivo a partir do processamento de outro.

Mesmo quando uma organização adota bancos de dados modernos, arquivos VSAM podem continuar presentes em partes da operação. A migração exige entender formatos de registros, chaves, dependências, programas consumidores e procedimentos de recuperação.

CICS e as transações on-line

O COBOL começou muito ligado ao processamento em lote, mas as empresas também precisavam executar operações interativas. Surgiu então a necessidade de controlar milhares de transações simultâneas realizadas por terminais, caixas eletrônicos e sistemas corporativos.

O CICS tornou-se uma das principais soluções para isso. Ele funciona como um servidor de aplicações transacionais, administrando execução, segurança, comunicação e acesso a recursos.

Um programa COBOL executado sob CICS pode consultar um cliente, registrar um pagamento, autorizar uma operação ou atualizar um cadastro. O usuário não precisa saber que existe COBOL atrás da interface.

O CICS Transaction Server atual não está restrito a terminais antigos. Ele oferece integração com aplicações de diferentes linguagens, observabilidade, APIs, automação e ferramentas de desenvolvimento modernas.

IMS: banco de dados e gerenciador de transações

O IMS, sigla de Information Management System, é outra tecnologia histórica encontrada em grandes ambientes corporativos. Ele reúne um banco de dados hierárquico e um gerenciador de transações.

Aplicações COBOL podem utilizar o IMS para consultar e atualizar estruturas de dados extremamente importantes. Em algumas organizações, essas bases carregam décadas de informações e continuam atendendo operações críticas.

O IMS permanece em evolução, com integração a Java, APIs REST, automação por Ansible e ferramentas voltadas à nuvem híbrida. A tecnologia é antiga, mas seu ambiente atual não corresponde necessariamente ao que existia nas décadas de 1970 ou 1980.

Db2 e o SQL embutido

Com a expansão dos bancos de dados relacionais, o Db2 passou a complementar muitas soluções COBOL. O programa pode conter comandos SQL embutidos para consultar, incluir, alterar ou excluir registros.

Isso aproximou o COBOL de um modelo de desenvolvimento ainda familiar: a aplicação executa regras de negócio enquanto o sistema de banco de dados organiza os dados, os índices, os bloqueios e as transações.

Conhecer SQL é, assim, uma habilidade valiosa para quem deseja trabalhar com COBOL corporativo. Em determinados projetos, entender o plano de acesso de uma consulta ou o impacto de um índice pode ser mais importante do que memorizar comandos da linguagem.

Mensageria, integração e sistemas distribuídos

À medida que novas plataformas foram surgindo, as aplicações COBOL precisaram conversar com sistemas Unix, Windows, Java, aplicações móveis, sites e serviços hospedados em nuvem.

Tecnologias de mensageria, como IBM MQ, passaram a transportar eventos e solicitações entre ambientes. Uma aplicação pode publicar uma mensagem que será processada por outro sistema, sem exigir que ambos estejam disponíveis exatamente no mesmo instante.

Gateways e plataformas de integração permitem que programas existentes sejam acessados por aplicações Java, .NET e outras linguagens. O CICS Transaction Gateway, por exemplo, conecta aplicações de diferentes plataformas aos serviços executados no CICS.

APIs REST e ferramentas como z/OS Connect levaram essa integração adiante. Uma aplicação de celular pode chamar uma API moderna que, internamente, aciona uma transação CICS escrita em COBOL. Para o usuário, tudo parece parte de uma única experiência digital.

O que realmente significa “tecnologia legada”?

O termo “legado” é frequentemente empregado como sinônimo de velho, ruim ou ultrapassado. Essa associação nem sempre é justa.

Um sistema legado é, antes de tudo, um sistema herdado. Ele foi construído em outro contexto tecnológico, mas continua necessário para o funcionamento da organização.

Existem sistemas COBOL bem estruturados, documentados e mantidos. Também existem sistemas Java recentes repletos de dependências problemáticas e decisões difíceis de corrigir. A idade da linguagem não determina, sozinha, a qualidade do software.

O problema surge quando uma aplicação acumula características como:

  • documentação incompleta;
  • regras de negócio conhecidas por poucas pessoas;
  • dependências que não foram mapeadas;
  • bibliotecas sem código-fonte;
  • compiladores muito antigos;
  • rotinas duplicadas;
  • ausência de testes automatizados;
  • processos manuais de implantação;
  • estruturas de dados difíceis de interpretar;
  • integrações sem responsáveis definidos.

Um programa com milhares de linhas pode incluir regras criadas após auditorias, mudanças tributárias, incorporações empresariais e exceções negociadas com clientes. Reescrever o código sem compreender esse histórico pode eliminar comportamentos aparentemente estranhos, mas essenciais.

Por isso, o maior valor de certas aplicações não está na sintaxe do COBOL. Está no conhecimento operacional codificado ao longo de décadas.

Por que não reescrever tudo?

A ideia de substituir uma aplicação COBOL por Java, C# ou outra linguagem parece simples em uma apresentação. A execução costuma ser bem mais delicada.

Uma reescrita integral precisa reproduzir o comportamento do sistema antigo, incluindo casos raros, arredondamentos, formatos de arquivos, rotinas de fechamento, integrações e procedimentos de recuperação.

Também existem particularidades como:

  • dados em EBCDIC;
  • campos numéricos em formato compactado;
  • copybooks compartilhados por muitos programas;
  • chamadas entre módulos;
  • processamento orientado a registros;
  • arquivos de largura fixa;
  • dependências entre tarefas em lote;
  • códigos de retorno usados para controlar cadeias de execução;
  • atualizações coordenadas entre COBOL, CICS, Db2, IMS e VSAM.

Converter a sintaxe não garante equivalência funcional. Uma tradução pode compilar corretamente e ainda produzir resultados diferentes em situações contábeis específicas.

A modernização responsável começa pelo inventário: quais programas existem, quem os chama, quais dados utilizam, quais regras executam e quais processos dependem deles. A própria IBM alerta que uma estratégia baseada somente na tradução do COBOL ignora a arquitetura de dados, a plataforma de execução e a integridade transacional do sistema.

A dificuldade de aprender COBOL no Brasil

A sintaxe básica do COBOL não é o maior obstáculo para novos profissionais. Com dedicação, alguém que já conhece lógica de programação pode aprender suas divisões, tipos de dados, estruturas condicionais, arquivos e subprogramas.

A dificuldade está em adquirir experiência semelhante à exigida por ambientes de produção.

Pouco espaço nas formações tradicionais

Cursos superiores e técnicos no Brasil costumam concentrar seus programas em Java, Python, JavaScript, desenvolvimento web, bancos de dados relacionais e computação em nuvem. Essa escolha é compreensível, pois essas tecnologias atendem um mercado amplo e são fáceis de praticar em computadores pessoais.

COBOL, JCL, CICS, IMS, RACF, VSAM e z/OS raramente aparecem juntos em uma graduação. Quando aparecem, muitas vezes são apresentados de maneira histórica, sem acesso a um ambiente real.

O estudante termina conhecendo a existência do COBOL, mas não necessariamente sabe compilar um programa no z/OS, submeter um job, analisar um abend, navegar por conjuntos de dados ou investigar uma transação CICS.

Acesso limitado ao ambiente completo

É possível instalar um compilador COBOL no Linux ou no Windows. Isso permite aprender a linguagem, criar programas e processar arquivos locais.

Reproduzir todo o ambiente corporativo é outra história. Um mainframe de produção envolve sistema operacional, segurança, catálogos, filas, bancos de dados, monitores transacionais, agendadores, ferramentas de desenvolvimento e padrões específicos de cada empresa.

O acesso a esses ambientes é controlado por razões óbvias. Eles armazenam informações financeiras, pessoais e comerciais. Dessa forma, boa parte do conhecimento mais valorizado é adquirida no emprego, em programas de formação interna ou em laboratórios especializados.

Forma-se um paradoxo: algumas vagas pedem experiência prática, mas o candidato só consegue essa experiência depois de entrar em uma organização que opere a plataforma.

O ecossistema é maior do que a linguagem

Uma pessoa pode escrever um programa COBOL correto e ainda não estar pronta para investigar um incidente em produção.

O trabalho pode exigir leitura de JCL, análise de códigos de retorno, conhecimento de Db2, controle de transações CICS, interpretação de arquivos VSAM, uso de TSO/ISPF, entendimento de copybooks, ferramentas de versionamento e regras internas de implantação.

Também é necessário conhecer o negócio. Um desenvolvedor que atua em sistemas bancários precisa compreender conceitos financeiros. Em seguros, precisa conhecer apólices, prêmios, sinistros e vigências. Em sistemas públicos, pode precisar interpretar normas e processos administrativos.

É justamente a combinação entre tecnologia e domínio de negócio que torna profissionais experientes difíceis de substituir.

Documentação e comunidades menores

Há muito menos conteúdo recente em português sobre COBOL e mainframe do que sobre desenvolvimento web. Vários materiais técnicos estão em inglês, e parte da documentação pressupõe acesso a produtos ou ambientes específicos.

As comunidades são menores e boa parte do código corporativo não pode ser publicada em repositórios públicos. Um desenvolvedor JavaScript encontra milhares de projetos completos para estudar. Já uma aplicação COBOL bancária real dificilmente estará disponível no GitHub, pois contém regras proprietárias e estruturas sensíveis.

Isso reduz a visibilidade do ecossistema e cria a impressão de que não existe trabalho. Na verdade, muitas oportunidades circulam em nichos formados por bancos, seguradoras, processadoras, empresas de serviços de tecnologia e consultorias.

Como começar a estudar COBOL hoje

Embora o acesso profissional continue sendo um desafio, o caminho de entrada melhorou consideravelmente.

Uma possibilidade é iniciar com GnuCOBOL em um computador pessoal. O compilador permite estudar estruturas de dados, arquivos, cálculos, subprogramas e diferentes dialetos sem depender imediatamente de um mainframe.

O Open Mainframe Project mantém um curso aberto de programação COBOL, com materiais que vão dos primeiros passos a tópicos avançados e testes. O projeto também apresenta ferramentas modernas de edição, integração com VS Code, Zowe, automação e pipelines de integração contínua.

Outra alternativa é o IBM Z Xplore, plataforma gratuita e baseada em desafios. Ela oferece contato prático com COBOL, JCL, VSAM, Db2, REXX, Linux e outros componentes do ecossistema IBM Z.

Uma trilha sensata pode seguir esta ordem:

  1. lógica de programação e estruturas de dados;
  2. sintaxe básica do COBOL;
  3. processamento sequencial de arquivos;
  4. tabelas, subprogramas e copybooks;
  5. JCL e execução de tarefas em lote;
  6. TSO, ISPF e organização de conjuntos de dados;
  7. VSAM;
  8. SQL e Db2;
  9. conceitos de CICS;
  10. depuração e análise de falhas;
  11. controle de versão, testes e automação;
  12. APIs e integração com aplicações modernas.

Projetos próprios ajudam a transformar o estudo em evidência prática. Um pequeno sistema de contas, uma folha de pagamento simulada ou um processador de arquivos de vendas pode demonstrar domínio da linguagem. O ideal é incluir testes, documentação, JCL de exemplo e uma descrição clara das regras implementadas.

Ainda assim, é preciso honestidade: um laboratório pessoal não equivale à experiência de sustentar um sistema crítico em produção. Ele serve como porta de entrada, não como substituto integral.

Como o COBOL ainda é usado

O COBOL permanece adequado a operações que reúnem grande volume, regras estáveis, cálculos comerciais e necessidade rigorosa de consistência.

Entre os usos mais comuns estão:

  • sistemas bancários centrais;
  • processamento de cartões;
  • liquidação de pagamentos;
  • folhas de pagamento;
  • faturamento;
  • previdência;
  • seguros;
  • cobrança;
  • sistemas tributários;
  • reservas e emissão de passagens;
  • gestão de grandes cadastros;
  • processamento de lotes financeiros;
  • relatórios regulatórios.

Isso não significa que o cliente interaja diretamente com uma “tela COBOL”. O aplicativo móvel pode ser desenvolvido em Swift ou Kotlin, o portal pode usar React e os serviços intermediários podem estar em Java, Go ou .NET. No centro da operação, uma transação COBOL pode validar e registrar a movimentação.

A arquitetura moderna frequentemente se parece com uma composição de camadas. O COBOL preserva a lógica central, enquanto APIs, mensageria e microsserviços oferecem novas formas de acesso.

Modernizar não é apenas migrar

Existem várias estratégias possíveis para uma aplicação COBOL:

  • manter o sistema e atualizar compiladores;
  • melhorar documentação e cobertura de testes;
  • otimizar programas sem alterar sua lógica;
  • expor funções existentes por meio de APIs;
  • substituir interfaces antigas;
  • integrar eventos e mensageria;
  • mover partes específicas para outra plataforma;
  • modularizar programas monolíticos;
  • converter somente serviços selecionados;
  • reescrever completamente uma aplicação;
  • aposentar sistemas que perderam sua função.

A melhor escolha depende do risco, do custo, da qualidade do código, da disponibilidade de profissionais e do valor comercial da aplicação.

Uma reescrita total pode ser adequada para um sistema pequeno e bem compreendido. Em uma aplicação central com milhões de transações e dependências acumuladas, a evolução incremental tende a oferecer maior controle.

Ambientes COBOL também estão incorporando Git, VS Code, pipelines de CI/CD, análise estática, testes automatizados, APIs e observabilidade. A existência de código antigo não obriga a equipe a utilizar processos antigos.

Inteligência artificial e compreensão de sistemas legados

Ferramentas de inteligência artificial começam a ser usadas para explicar programas, mapear dependências, produzir documentação, sugerir testes e auxiliar na refatoração.

O watsonx Code Assistant for Z, por exemplo, oferece recursos de descoberta de aplicações, explicação de código, geração de COBOL, refatoração modular e transformação assistida para Java.

Essas ferramentas podem reduzir o tempo necessário para navegar por grandes bases de código. Elas não eliminam a necessidade de especialistas.

Nomes de campos abreviados, regras não documentadas e comportamentos históricos exigem contexto organizacional. Uma inteligência artificial pode interpretar a estrutura do programa, mas não necessariamente sabe por que uma determinada exceção foi criada vinte anos atrás.

O uso seguro exige testes de regressão, validação de resultados, revisão humana e participação das áreas de negócio. Em aplicações financeiras e governamentais, “parece equivalente” não é um critério suficiente.

O futuro do COBOL

É improvável que o COBOL volte a ocupar posição central nos cursos de programação ou se transforme em uma linguagem popular entre iniciantes. Também é improvável que desapareça rapidamente.

Seu futuro deve ser marcado por uma redução gradual de alguns sistemas, combinada à modernização e manutenção de outros. Certas aplicações serão reescritas. Outras permanecerão em COBOL, mas ganharão APIs, monitoramento, automação, interfaces modernas e integração com ambientes distribuídos.

O padrão publicado em 2023, os compiladores atualizados, os projetos de código aberto e as ferramentas contemporâneas de desenvolvimento mostram que a linguagem ainda evolui. O próprio mercado de mainframe busca renovar profissionais: a IBM anunciou em 2024 um Mainframe Skills Council e programas de formação voltados a desenvolvedores, administradores e arquitetos de modernização.

Para o profissional brasileiro, COBOL provavelmente continuará sendo uma especialização. A quantidade de vagas pode ser menor do que em Java ou JavaScript, mas o conhecimento exigido também é mais raro. O perfil mais valorizado não será o de quem conhece somente a sintaxe da linguagem, e sim o de quem consegue compreender sistemas inteiros.

Esse profissional precisará transitar entre dois mundos: COBOL e APIs, lote e tempo real, ISPF e VS Code, arquivos tradicionais e bancos relacionais, mainframe e nuvem, regras escritas há décadas e novos produtos digitais.

A linguagem criada em 1959 não sobreviveu porque o tempo parou. Ela sobreviveu porque as organizações continuaram operando, acumulando regras e construindo novas camadas ao redor de sistemas que já funcionavam.

Compreender COBOL é também compreender que a história da computação não é feita apenas de substituições. Muitas vezes, ela avança por integração, adaptação e convivência entre tecnologias de épocas diferentes.